一句话结论(TL;DR):2026 年 11 月 7 日发布的《指挥与控制建模仿真十大前沿问题》,本质上是一份「算力需求清单」——大规模超实时并行仿真吃核心数与内存带宽,智能体/MARL 训练吃 GPU 显存与互联,蒙特卡洛批量实验吃多核并行与快照 IO,可信性评估吃大内存与统计算力。UltraLAB 全水冷产品线(A350 → GR450P → EA660 → AlphaPro660)可按「单机推演 — 课题组共享 — 院级超实时平台」三级精准匹配,¥52,000 起步、¥999,900 封顶,避免"买贵"或"买错"。
| 文档属性 | 内容 |
|---|---|
| 关键词 | 指挥与控制建模仿真、十大前沿问题、超实时并行仿真、多智能体强化学习、蒙特卡洛实验、HLA/RTI、智能蓝军、无人集群、UltraLAB 工作站、仿真算力配置 |
| 目标读者 | 国防科研院所、军工集团仿真中心、高校建模仿真团队、指控系统总体单位、仿真软件开发商 |
| 热点事件 | 2026-11-07 首届指挥与控制建模仿真大会,中国指挥与控制学会建模与仿真专业委员会发布《十大前沿问题》 |
| 更新日期 | 2026-11-17 |
| 适用报价基线 | UltraLAB 图形工作站基准配置表 2026v3 |
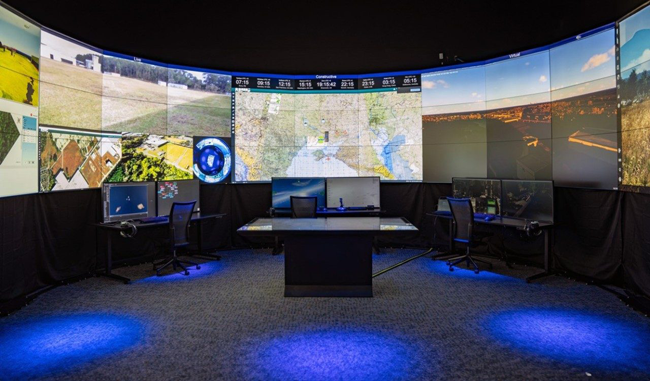
图1|《指挥与控制建模仿真十大前沿问题》发布现场:历时 10 个月论证,从 341 条提案中凝练 10 大问题
本文导航(Table of Contents)
- 核心内容应用分析:十大前沿问题到底在问什么
- 主要核心算法及计算特点
- 硬件瓶颈分析:算力卡在什么地方
- 应用场景及 UltraLAB 机型推荐
- 软件清单(预装建议)
- 具体硬件配置及价格部署方案
- 常见问题硬件配置分析(FAQ)
- 结语与采购建议
一、核心内容应用分析:十大前沿问题到底在问什么 { #sec1-title}
1.1 发布背景:一份"问题清单"定义了未来五年的算力坐标
2026 年 1 月起,中国指挥与控制学会建模与仿真专业委员会历时 10 个月,按「提案征集 → 专家初评 → 公示投票 → 专家评议 → 终评定稿 → 成果发布」六阶段组织论证:共收到 341 条问题提案,初评筛出 57 条入围提案,网上公示投票全国 3879 人参与,最终于 2026 年 11 月 7 日首届指挥与控制建模仿真大会正式发布十大前沿问题,从基础理论、关键技术、工程应用三个维度为指控建模仿真领域"定义发展坐标"。
对硬件采购而言,这份清单的信号非常明确:传统集中式仿真在规模与效率上已无法支撑智能指控决策,"数万级实体协同、秒级决策、万倍以上加速"成为新一代仿真系统的硬指标——算力基础设施必须同步换代。
1.2 十大前沿问题全景表(内涵 → 算力画像)
| 序号 | 前沿问题 | 核心科技内涵 | 算力需求画像 |
|---|---|---|---|
| 问题一 | 智能时代指控系统仿真架构 | 云化弹性、随需重构的仿真环境;多域模型语义级互操作;虚实低时延交互 | 云化资源调度 + 高并发容器,吃核数/内存/虚拟化 |
| 问题二 | 支撑智能指控的大规模超实时多引擎并行仿真 | 数万级实体、多引擎兼容、万倍以上加速比;蒙特卡洛重复实验编排 | 核心数 × 内存带宽 × 快照 IO,超算级并行 |
| 问题三 | 智能体参与下的联合作战指控体系建模 | 智能体嵌入指控体系,组织与决策方式体系性变化 | 智能体并发推理,吃 GPU 显存 + 多核 CPU |
| 问题四 | 指控体系智能对抗建模仿真 | 红蓝对抗、博弈演化、对抗样本生成 | MARL 训练,吃多卡 GPU + NVLink |
| 问题五 | 分布式杀伤网构建、运行和调控建模仿真 | 杀伤网动态构建与调控、跨域杀伤链闭合分析 | 图计算 + 优化求解,吃高频多核 + 大内存 |
| 问题六 | 跨模态战场态势认知 AI-物理融合模型 | 多源异构传感数据融合、神经-物理混合建模 | 视觉/多模态模型训练,吃大显存 GPU |
| 问题七 | 指挥员行为智能建模方法 | 认知建模、大模型驱动指挥员智能体 | LLM 本地推理,吃显存/内存容量 |
| 问题八 | 智能蓝军战术自主行为建模仿真 | 自主战术决策、涌现性/黑盒化行为 | RL 训练 + 并行采样,GPU 训练 + CPU 采样异构 |
| 问题九 | 无人集群协同作战效果涌现建模 | 数万实体交互、去中心化受控涌现 | 大规模 ABMS,吃核心数与缓存 |
| 问题十 | 智能指控仿真模型的可信性评估 | 开放行为空间下的 VV&A、不确定性量化 | 海量重复实验 + 统计推断,吃多核 + 大内存 |
1.3 三条产业主线
- 主线 A|仿真基础设施换代:问题一、问题二指向"云化弹性 + 超实时并行"的仿真底座——这是双路多核大内存平台的主战场。
- 主线 B|智能化建模方法:问题三、六、七、八、九指向"智能体 + 大模型 + 强化学习"全面进入仿真回路——这是 GPU 算力的主战场。
- 主线 C|可信与工程化:问题四、五、十指向对抗、杀伤网与可信评估——需要批量实验编排与统计分析能力,吃均衡型异构平台。
二、主要核心算法及计算特点 { #sec2-title}
十大前沿问题背后,是 8 类可明确"点名"的核心算法。理解算法的并行模式,才能理解硬件该怎么配。
2.1 并行离散事件仿真(PDES)——超实时推演的引擎底座
指控体系推演的本质是离散事件仿真:实体状态在事件时刻跳变,时间推进靠事件队列调度。要做到"万倍超实时",必须将仿真分解到多核并行执行(Parallel DES):
| 子算法 | 机制 | 计算特点 | 硬件敏感点 |
|---|---|---|---|
| 保守同步(Conservative) | 严格因果约束,空消息/前瞻量协调 | 同步开销大、串行段长 | 单核频率、核间延迟 |
| 乐观同步(Time Warp) | 允许超前执行,冲突时回滚 + 状态恢复 | 频繁状态快照/回滚,内存随机访问密集 | L3 缓存容量、内存带宽 |
| 事件调度与时间推进 | 优先队列(堆/日历队列)维护 | 本质串行的热点代码路径 | 单核主频(5GHz 级收益显著) |
关键洞察:PDES 是"频率 + 缓存 + 核数"三敏感的典型负载。乐观同步下,数万实体的状态快照在内存中高频随机读写——这正是 AMD 霄龙 3D V-Cache(768MB~1.5GB L3) 的甜区。
2.2 蒙特卡洛重复实验编排——批量实验的" embarrassingly parallel "负载
问题二明确要求"海量蒙特卡洛重复实验,分离并量化概率性因素对推演结论的影响"。其特征是:
- 天然并行:每次实验相互独立,可线性扩展到全部物理核心,加速比≈核数;
- 随机种子与状态快照管理:分布式环境下需一致性保障,产生大量快照写入与结果聚合 IO(NVMe 敏感);
- 长尾效应:少数极端想定耗时远超均值,需要核数冗余吸收长尾。
2.3 多智能体建模仿真(ABMS)与受控涌现
问题三、五、九的公共底座。数万实体的交互关系随规模呈平方级增长,联合行为空间指数膨胀:
| 计算环节 | 特点 | 硬件敏感点 |
|---|---|---|
| 邻域查询/碰撞检测 | 空间哈希、kd-tree,随机内存访问 | 缓存容量、内存延迟 |
| 实体规则更新 | 数十万 Agent 逐 tick 更新 | 核心数、AVX-512 向量化 |
| 聚合/解聚(多分辨率建模) | 场景自适应聚合简化 | 单核频率 + 内存容量 |
2.4 多智能体强化学习(MARL)——智能蓝军与对抗建模的训练范式
问题四、八的核心技术路线:QMIX/MAPPO/MADDPG 等算法在仿真环境中并行采样、GPU 集中训练。
- 异构流水线:N 路仿真环境实例在 CPU 上并行采样(吃核数),策略网络在 GPU 上批量训练(吃显存与算力);
- 经验回放池:百万级 transition 驻留内存(内存容量敏感);
- 自我博弈(Self-Play):历史策略库常驻显存,48GB+ 显存才能容纳大规模策略种群。
2.5 大模型驱动的指挥员/参谋智能体(LLM-Agent)
问题七的方向:用 DeepSeek、Qwen 等开源大模型构建"指挥员认知智能体",嵌入推演回路。
- 推理负载:70B Q4 模型约需 43GB 显存;671B Q4 约 400GB 可用大内存 CPU 推理兜底;
- 多智能体并发:一场推演可能同时驻留数十个 LLM-Agent,显存容量与内存容量是第一约束;
- RAG 知识库:条令、战例库向量化检索,吃内存与 NVMe 随机读。
2.6 HLA/RTI 分布式联邦仿真
问题一"多引擎兼容、虚实互联"的工程标准。多联邦成员经 RTI 进行时间管理(保守/乐观)与数据分发(DDM):
- 计算节点间时钟协调与结果一致对网络延迟/带宽敏感(40G 以太网起步);
- 联邦成员本身是多进程/多线程程序,吃核数与核间通信。
2.7 跨模态态势认知:AI-物理融合模型
问题六的神经-物理混合建模:CNN/ViT 处理侦察影像,物理约束(PINN/代理模型 Surrogate)保证外推可信。
- 训练侧:多模态大 batch 训练,吃 GPU 显存 + 张量核心;
- 推理侧:秒级态势预判要求低延迟推理(TensorRT 优化 + 大显存驻留)。
2.8 可信性评估与不确定性量化(VV&A / UQ)
问题十:智能行为"期望输出无法先验规约",校核验证需海量样本的统计推断——假设检验、敏感性分析(Sobol 指数)、贝叶斯校准,均为多核 + 大内存负载。
2.9 算法—算力映射总表
| 核心算法 | 并行模式 | 第一硬件指标 | 第二硬件指标 |
|---|---|---|---|
| PDES 乐观同步 | 多核并行 + 回滚 | L3 缓存 | 单核频率 |
| 蒙特卡洛批量实验 | 任务级天然并行 | 核心数 | NVMe 快照 IO |
| ABMS 群体行为 | 数据并行 | 核心数 + 缓存 | 内存容量 |
| MARL 训练 | CPU 采样 + GPU 训练 | GPU 显存 | CPU 核数 |
| LLM-Agent 推理 | 显存驻留推理 | 显存容量 | 内存容量(offload) |
| HLA 联邦仿真 | 分布式消息 | 网络带宽/延迟 | 核间通信 |
| 跨模态融合 | GPU 张量计算 | 张量算力 | 显存容量 |
| UQ/统计推断 | 批量样本并行 | 核心数 | 内存容量 |
三、硬件瓶颈分析:算力卡在什么地方 { #sec3-title}
3.1 CPU:核数决定"实验吞吐",频率决定"推演延迟"
- 超实时加速比天花板:万倍加速 = 并行效率 × 核心规模。64 核是入门,128~256 核才能把一次想定推演压进"秒级窗口";
- 串行段陷阱:事件调度、RTI 时间管理等热点路径本质串行——4.5~5.0GHz 高频机型比低频多核机型的实测推演延迟低 30% 以上;
- 缓存墙:数万实体状态随机访问,主存延迟成为瓶颈。768MB~1.5GB 3D V-Cache 让热实体数据不离开 CPU,实测可比同频普通型号提速 30%+。
3.2 内存:容量决定"实体规模上限",带宽决定"刷新率"
经验估算:每个仿真实体状态向量 4~40KB(含武器/传感/决策状态)——
| 实体规模 | 状态内存 | 加实验快照×并发后建议内存 |
|---|---|---|
| 1 万实体 | 0.4~4GB | 192GB 起步 |
| 5 万实体 | 2~20GB | 384~512GB |
| 10 万+ 实体 / 多引擎并发 | 4~40GB+ | 768GB~1.5TB |
再加蒙特卡洛并发实验(每实例独立状态空间)与 MARL 经验回放池,512GB 是课题组级甜点,768GB~1.5TB 是院级平台门槛。
3.3 GPU:显存容量决定"模型能不能跑",算力决定"训练快不快"
| 负载 | 显存门槛 | 推荐显卡档位 |
|---|---|---|
| 3D 态势可视化(大屏/头盔) | 16~24GB | RTX 5080 / 5090D |
| 7B~14B 指挥员 Agent 推理 | 16~32GB | RTX 5090 32GB |
| 70B Q4 大模型推理 | ~43GB | RTX Pro 5090 48GB / RTX Pro 6000 96GB |
| MARL 自我博弈训练 | 48~96GB | RTX Pro 6000 / A100 80GB |
| 70B 级模型微调 / 跨模态预训练 | 80~141GB | A100 80G / H100 80G / H200 141GB |
3.4 存储 IO:被低估的"快照瓶颈"
- 乐观同步回滚、蒙特卡洛状态快照、实验结果聚合,都会产生百万级小文件随机写——SATA SSD 直接成为系统瓶颈;
- NVMe Gen5(14GB/s)+ 分层存储(NVMe 热数据 + SATA 归档)是批量实验的标配。
3.5 网络与散热:分布式与 7×24 的隐性约束
- HLA 联邦多节点互联、虚实装备在环(LVC)低时延交互:40G 以太网起步,时延抖动直接影响因果保序;
- 批量实验常以"天"为单位满载运行:全水冷保障 5GHz 超频长期不降频,同时把噪音压到指挥中心可接受的水平——超频性能"跑满",而不是"跑一分钟"。
四、应用场景及 UltraLAB 机型推荐 { #sec4-title}
4.1 场景—问题—机型映射总表
| 应用场景 | 对应前沿问题 | 算力画像 | 推荐 UltraLAB 机型 | 参考价 |
|---|---|---|---|---|
| A. 单机推演与态势可视化终端 | 问题一、六 | 高频 CPU + 大显存 GPU,帧率敏感 | A350 系列 / GR450P 系列 | ¥52,000 起 |
| B. 大规模超实时并行仿真 | 问题二、九 | 128~256 核 + 大内存 + 大缓存 | EA660 / AlphaPro660 | ¥252,000 起 |
| C. 蒙特卡洛批量实验与可信性评估 | 问题二、十 | 核数优先 + NVMe 快照 IO | EA650/EA660 双路系列 | ¥89,990 起 |
| D. 智能蓝军 / MARL 对抗训练 | 问题四、八 | 多核采样 + 大显存训练 | AlphaPro660(H100/H200) | ¥670,000 起 |
| E. 指挥员大模型智能体(LLM-Agent) | 问题三、七 | 70B~671B 本地推理 | EX660(48G 显存)/ AlphaPro660 T1 | ¥385,000 起 |
| F. 跨模态态势认知模型研发 | 问题六 | 多卡训练 + 大显存 | GA650M 4 卡平台 | 询价 |
| G. 杀伤网优化与体系贡献率分析 | 问题五 | 高频多核 + 图计算 | GT430P / GR450P 超频系列 | ¥92,000 起 |
4.2 场景 A:单机推演与 3D 态势可视化(GPU 帧率优先)
面向仿真工程师日常开发调试、想定编辑、三维态势大屏演示。
| 推荐机型 | 核心配置 | 适用 | 参考价 |
|---|---|---|---|
| A350156128-MCX | 24 核(P 核 5.5GHz)/ 128GB / RTX 5070Ti 16G / 4TB NVMe | 推演客户端开发、中等规模场景演示 | ¥52,000 |
| A350153128-MCT | 20 核 / RTX 5090D v2 24GB / 4TB+8TB | 城市级三维战场环境流畅加载 | ¥76,000 |
| A35015396-MCT | 锐龙 9950X3D 16 核 / RTX 5090D 32G 水冷 | 大场景粒子特效全开 + 7B Agent 入门 | ¥89,990 |
| GR450P15064-MCT | 撕裂者 7970X 32 核 5.0GHz / RTX 5090D v2 24G | 推演 + 模型预处理一机多用 | ¥108,000 |
选型逻辑:可视化终端硬指标是显存(16G 起步、24~32G 从容),调度线程吃单核主频——UltraLAB A350/GR450P 全系水冷超频 5GHz+,同时喂饱渲染与事件调度。
4.3 场景 B/C:超实时并行仿真 + 蒙特卡洛批量实验(核心数 × 内存带宽优先)
问题二"万倍超实时"的落地平台,也是可信性评估(问题十)的批量实验底座。
| 推荐机型 | 核心配置 | 适用 | 参考价 |
|---|---|---|---|
| EA650 230192-MBX | 2×霄龙 7573X(64 核 3.0GHz,2×768MB L3)水冷 / 192GB / RTX 5060Ti 16G | 双路入门:中等规模批量实验、5 万实体推演 | ¥89,990 |
| EA650 230256-MCX | 2×霄龙 7773X(128 核,1.5GB L3)/ 256GB | 流体级大规模 ABMS、批量蒙特卡洛 | ¥132,000 |
| EA660 235512-MCX | 2×霄龙 9654(192 核 3.4GHz)/ 512GB DDR5 / RTX 5080 | 数万实体协同 + 千组并发实验 | ¥252,000 |
| EA660 245512-MCX | 2×霄龙 9575F(128 核 4.5GHz)/ 384GB DDR5 | 频率极致:低延迟在线推演、时域敏感负载 | ¥323,000 |
| EA660 235768-MCT | 2×霄龙 9755(256 核 3.5GHz)/ 768GB / RTX 5090 32G 水冷 | 院级批量实验平台、5~10 人 AI 服务并发 | ¥420,000 |
选型逻辑:批量实验是"任务级天然并行"——核数即吞吐;PDES 乐观同步下大缓存直接降低回滚成本;512GB+ ECC 内存保障 7×24 实验位翻转无忧。
4.4 场景 D/E/F:智能体训练与大模型推理(GPU 显存优先)
智能蓝军(问题八)、指挥员 Agent(问题七)、跨模态认知(问题六)的 AI 算力平台。
| 推荐机型 | 核心配置 | 适用 | 参考价 |
|---|---|---|---|
| EX660 229512-MCD | 2×Xeon 铂金 8592+(128 核)/ 512GB / RTX Pro 5090 48GB | 70B Q4 指挥员 Agent GPU 推理 + MARL 中等规模训练 | ¥385,000 |
| AlphaPro660 234512-MCT | 2×霄龙 9684X(192 核 3.5GHz,超大缓存)/ 512GB / RTX 5090 32G | 数值模拟 + 32B Agent 推理旗舰入口 | ¥330,000 |
| AlphaPro660 241768-MCA | 2×霄龙 9755(256 核 4.1GHz)/ 768GB / A100 80GB 水冷 | 共享虚拟超算:5~8 人并发 MARL/仿真混合负载 | ¥499,900 |
| AlphaPro660 2411T-MCH | 256 核 / 1TB DDR5 / H100 80GB 水冷 | 大规模 MARL 训练 + 140B 模型内存推理 | ¥670,000 |
| AlphaPro660 T1 | 256 核 / 1.5TB DDR5 / H200 141GB / 8TB NVMe(14GB/s) | 671B 大模型私有化、70B FP16 全精度、国家级项目底座 | ¥999,900 |
选型逻辑:MARL 是"CPU 采样 + GPU 训练"异构流水线——256 核并行采样喂饱 H100/H200;LLM-Agent 则先算显存账:70B Q4≈43GB、671B Q4≈400GB,显存不够就用大内存 CPU 推理兜底。
4.5 场景 G:杀伤网优化与体系分析(频率 + 图计算)
问题五的杀伤网构建/调控本质是大规模图优化(组合优化、网络流、博弈求解):
| 推荐机型 | 核心配置 | 适用 | 参考价 |
|---|---|---|---|
| GT430P15164-MCX | Xeon W7-2475X 20 核 5.1GHz 超频 / RTX 5080 16G | 杀伤链闭合分析、MIP/LP 求解 | ¥92,000 |
| GR450P150128-MCX | 撕裂者 7975WX 32 核 5.0GHz / 128GB / RTX 5080 | 大规模图计算 + 并行优化 | ¥128,000 |
| AE4507773X64-MCX | 霄龙 7773X 64 核 / 768MB 3D 缓存 / RTX 5070Ti | 图随机访问密集的大数据分析 | ¥79,990 |
五、软件清单(预装建议) { #sec5-title}
5.1 操作系统与基础环境
| 类别 | 软件 |
|---|---|
| 操作系统 | Ubuntu 22.04/24.04 LTS、Windows 11 Pro、银河麒麟 V10(信创/涉密环境) |
| 容器与运行时 | Docker、Apptainer、NVIDIA Container Toolkit |
| 并行环境 | OpenMPI、MPICH、OpenMP、CUDA Toolkit、Spack |
| 作业调度 | Slurm(批量实验编排)、Ray(分布式 RL/批量任务) |
5.2 建模仿真引擎与联邦中间件
| 类别 | 软件 |
|---|---|
| 作战仿真引擎 | AFSIM、VR-Forces、STAGE、FLAMES、EADSIM、JTLS-GOF、OneSAF |
| 国产仿真平台 | 墨子·联合作战推演系统、XSimStudio(华如)等 |
| HLA/RTI 中间件 | Pitch pRTI、MAK RTI、CERTI(开源) |
| 多智能体仿真 | Repast、NetLogo、Mesa(Python)、MAgent2 |
| 系统仿真 | MATLAB/Simulink、AnyLogic、SimPy |
5.3 AI 训练与大模型
| 类别 | 软件 |
|---|---|
| 深度学习框架 | PyTorch 2.x、TensorFlow、JAX |
| 强化学习 | Ray RLlib、PyMARL、PettingZoo、Stable-Baselines3、Tianshou |
| 大模型推理 | vLLM、llama.cpp/Ollama、Triton Inference Server |
| 开源模型 | DeepSeek-V3/R1、Qwen3 系列(7B~671B 按需量化部署) |
| 跨模态/视觉 | PaddleRS、TorchGeo、MMDetection、Segment Anything |
5.4 可视化与实验分析
| 类别 | 软件 |
|---|---|
| 三维态势 | CesiumJS / Cesium for Unreal、osgEarth、Unity、Unreal Engine 5 |
| 科学可视化 | ParaView、VTK、Tecplot |
| 实验设计与统计 | JMP、R/Python(SciPy、statsmodels、SALib 敏感性分析)、DESIGN-EXPERT |
| 数据管理 | PostgreSQL/PostGIS、ClickHouse(实验结果聚合分析) |
六、具体硬件配置及价格部署方案 { #sec6-title}
6.1 三级部署架构
| 层级 | 定位 | 典型用户 | 推荐组合 | 预算区间 |
|---|---|---|---|---|
| 一级:单机推演终端 | 开发调试 / 态势演示 | 仿真工程师个人 | A350156128-MCX | ¥52,000 |
| 二级:课题组共享平台 | 批量实验 / 中等规模 MARL | 5~15 人课题组 | EA660 235512-MCX + GR450P15064-MCT | ¥36 万级 |
| 三级:院级超实时仿真底座 | 数万实体超实时 + 大模型服务 | 研究院仿真中心 | EA660 235768-MCT ×2 + AlphaPro660 2411T-MCH + EX660 229512-MCD | ¥190 万级 |
6.2 推荐部署清单(二级:课题组共享平台,约 ¥36 万)
| 节点 | 机型 | 配置要点 | 角色 | 单价 |
|---|---|---|---|---|
| 计算节点 | EA660 235512-MCX | 192 核 3.4GHz / 512GB DDR5 / RTX 5080 / 4TB NVMe | 批量实验 + 超实时推演 | ¥252,000 |
| 开发/可视化节点 | GR450P15064-MCT | 32 核 5.0GHz / RTX 5090D 24G | 模型开发 + 三维态势 | ¥108,000 |
| 合计 | — | — | — | ¥360,000 |
6.3 推荐部署清单(三级:院级仿真底座,约 ¥190 万)
| 节点 | 机型 | 配置要点 | 角色 | 单价 |
|---|---|---|---|---|
| 批量实验节点 ×2 | EA660 235768-MCT | 256 核 3.5GHz / 768GB / RTX 5090 32G | 蒙特卡洛实验池(共 512 核) | ¥420,000 ×2 |
| AI 训练节点 | AlphaPro660 2411T-MCH | 256 核 / 1TB / H100 80G 水冷 | MARL 训练 + 140B 推理 | ¥670,000 |
| 大模型服务节点 | EX660 229512-MCD | 128 核 / 512GB / RTX Pro 5090 48G / 40G 以太网 | 70B 指挥员 Agent 在线服务 | ¥385,000 |
| 互联 | 40G 以太网交换 | HLA 联邦低时延互联 | 联邦仿真骨干 | 询价 |
| 合计 | — | — | — | 约 ¥1,895,000 |
6.4 全系关键配置价格速查表(2026v3)
| 机型 | CPU | 内存 | GPU | 参考价 | 一句话定位 |
|---|---|---|---|---|---|
| A350156128-MCX | 24 核 5.5GHz | 128GB | RTX 5070Ti 16G | ¥52,000 | 推演终端入门 |
| AE4507573X32-MCX | 霄龙 7573X 32 核 / 768MB 缓存 | — | RTX 5060Ti | ¥59,990 | 大缓存性价比之王 |
| AE4507773X64-MCX | 霄龙 7773X 64 核 / 768MB 缓存 | — | RTX 5070Ti | ¥79,990 | 图计算/批处理甜点 |
| EA650 230192-MBX | 2×7573X 64 核 | 192GB | RTX 5060Ti 16G | ¥89,990 | 双路超算入门 |
| GT430P15164-MCX | Xeon W7-2475X 20 核 5.1GHz | — | RTX 5080 16G | ¥92,000 | 高频杀伤网分析 |
| GR450P15064-MCT | 撕裂者 7970X 32 核 5.0GHz | 64GB | RTX 5090D 24G | ¥108,000 | 高频多核一机多用 |
| EA650 230256-MCX | 2×7773X 128 核 | 256GB | RTX 5060Ti 16G | ¥132,000 | 大规模 ABMS |
| EA660 235512-MCX | 2×9654 192 核 3.4GHz | 512GB | RTX 5080 | ¥252,000 | 批量实验主力 |
| EA660 245512-MCX | 2×9575F 128 核 4.5GHz | 384GB | RTX 5080 | ¥323,000 | 低延迟在线推演 |
| AlphaPro660 234512-MCT | 2×9684X 192 核 3.5GHz | 512GB | RTX 5090 32G | ¥330,000 | 数值模拟旗舰入口 |
| EX660 229512-MCD | 2×Xeon 8592+ 128 核 | 512GB | RTX Pro 5090 48G | ¥385,000 | 70B Agent + 异构超算 |
| EA660 235768-MCT | 2×9755 256 核 | 768GB | RTX 5090 32G | ¥420,000 | 桌面超算批量实验 |
| AlphaPro660 241768-MCA | 2×9755 256 核 4.1GHz | 768GB | A100 80G | ¥499,900 | 共享虚拟超算 |
| AlphaPro660 2411T-MCH | 2×9755 256 核 | 1TB | H100 80G | ¥670,000 | 大规模 MARL 训练 |
| AlphaPro660 T1 | 2×9755 256 核 | 1.5TB | H200 141G | ¥999,900 | 671B 私有化终极形态 |
注:价格为 UltraLAB 基准配置表 2026v3 参考价,实际以厂商最新报价为准;涉密/信创环境可选麒麟 OS + 国产 GPU 适配方案。
七、常见问题硬件配置分析(FAQ) { #sec7-title}
Q1:做万倍超实时蒙特卡洛批量实验,为什么核心数比主频更重要?蒙特卡洛重复实验是"任务级天然并行"负载——每次实验互不依赖,加速比近似等于物理核心数。64 核平台一天跑完的实验量,192 核平台只需 8 小时。预算有限时,先堆核数(EA650 ¥89,990 起),再考虑主频;只有当单次推演延迟成为硬指标(在线决策秒级窗口)时,才需要 4.5~5.0GHz 高频机型(EA660 245512-MCX / GT430P)。
Q2:PDES 乐观同步(Time Warp)老在回滚,换什么 CPU 最有效?乐观同步的开销主要在状态快照的保存与恢复——海量实体状态的随机内存访问。换用 3D V-Cache 大缓存霄龙(7573X/7773X/9684X,768MB~1.5GB L3)可让热状态不离开缓存,实测回滚开销显著下降;同时检查回滚频率是否因前瞻量(lookahead)设置过小,这属于算法参数问题,不是硬件问题。
Q3:训练"智能蓝军"(MARL),GPU 显存和数量怎么算?经验公式:显存需求 ≈ 策略网络参数 ×2(训练态)+ 自我博弈策略库 + 批量观测张量。中小型 MARL(百万级参数策略网)48GB 单卡(RTX Pro 5090)足够;大规模自我博弈 + 视觉观测(战场图像输入)建议 80GB 起步(A100/H100)。采样端用 CPU——256 核并行环境实例才能喂饱一张 H100(AlphaPro660 2411T-MCH 即按此比例设计)。
Q4:指挥员大模型智能体想本地部署 70B/671B,最低什么配置?- 70B Q4(约 43GB):一张 48GB 显卡即可 GPU 推理(EX660 229512-MCD,¥385,000);
- 70B 全精度 FP16(约 140GB):H200 141GB 单卡刚好(AlphaPro660 T1);
- 671B Q4(约 400GB):只能用大内存 CPU 推理——1.5TB DDR5 的 AlphaPro660 T1 可加载,速度约 2~8 token/s,适合后台批量分析而非实时对话;
- 涉密单位本地化部署的价值在于数据不出域——这正是大内存平台的战略意义。
不够。联邦成员间的状态同步与时间管理消息在高实体规模下可达每秒数十万次;虚实交互(装备在环)对时延抖动敏感——抖动会直接破坏因果保序。建议 40G 以太网起步(EX660 229512-MCD 已标配),多节点超实时联邦考虑 100G/IB。
Q6:双路 256 核平台能放办公室吗?散热噪音怎么解决?双路 256 核 + 高端 GPU 满载功耗 1000~2000W,风冷方案噪音可达 50~70 分贝。UltraLAB 全水冷设计把 CPU/GPU 热量直接带走,长期满载不降频、噪音显著低于风冷——EA660/AlphaPro660 可放设备间远程使用;办公室内使用建议 GR450P/A350 单路水冷机型。
Q7:可信性评估(问题十)为什么要单独配大内存统计节点?UQ/VV&A 的典型流程是"海量实验 → 结果聚合 → 统计推断":百万级实验结果装载进内存做敏感性分析(Sobol 指数、贝叶斯校准)时,数据集常达百 GB 级。512GB 内存 + 高内存带宽的 EA660 235512-MCX 可全内存完成分析,避免反复落盘——实验吞吐和统计吞吐是两条并行的算力线。
Q8:仿真工作站能替代超算中心吗?不能替代,但可避免排队。超算适合千万级实体的生产性任务;UltraLAB 双路平台适合前期调试、参数寻优、中小规模批量实验与涉密任务——独占使用、无需排队、数据不出域。最佳实践是"工作站做研发迭代 + 超算做规模生产"的两级模式。
八、结语与采购建议 { #sec8-title}
《十大前沿问题》给出的方向非常清晰:仿真正在从"离线推演工具"变成"在线决策基础设施"——万倍超实时、智能体嵌入、大模型驱动、可信性评估,每一条都直接转化为算力需求。给三类读者的建议:
- 刚立项的课题组:从 EA650 230192-MBX(¥89,990,64 核 + 1.5GB L3)起步,先解决"批量实验跑起来";
- 承担型号/预研任务的团队:EA660 235512-MCX(192 核)+ GR450P(高频可视化)的 ¥36 万组合是性价比最优解;
- 院级仿真中心/总体单位:按「批量实验池 + AI 训练节点 + 大模型服务节点」三级架构部署,¥190 万级底座可覆盖十大问题中的全部算力场景。
UltraLAB 支持远程测试、按应用匹配、算法级调优——带着你的仿真负载实测后再下单,比看参数表更可靠。
图2|UltraLAB 三级部署架构:从 ¥5.2 万推演终端到 256 核 + H200 院级仿真底座
免责声明:本文基于《指挥与控制建模仿真十大前沿问题》公开发布内容与 UltraLAB 图形工作站基准配置表 2026v3 整理撰写,硬件配置与价格以厂商最新报价为准。文中仿真性能数据为工程经验估算,实际表现受模型规模、并行效率、算法实现等多因素影响,建议以实际负载测试为准。
版权说明:转载请注明出处;"十大前沿问题"内容版权归中国指挥与控制学会建模与仿真专业委员会所有。