






一句话结论:这类"天线-基带-算法全流程"科研套件把射频链路的脏活累活都做完了,高校和课题组买到手的核心价值是算法验证环境。但别忽略一个事实:8通道 × 2.5Gsps 的 IQ 数据洪流 ≈ 35GB/s——套件能采,不代表你的电脑接得住、存得下、算得动。上位机与离线分析平台,才是决定科研效率的隐形主角。
本文导航:一、套件架构与应用分析 · 二、核心算法解析 · 三、计算特点与算力瓶颈 · 四、应用场景 · 五、UltraLAB硬件配置怎么选 · 六、软件清单 · 七、FAQ硬件配置分析
一、套件架构与应用分析:买到手的到底是什么
以近期发布的 0.2-18GHz 8通道侦测-识别-测向-干扰一体化科研套件为样本,其设计思路是"射频硬件商品化 + 算法接口开放化",让科研单位聚焦核心算法而非重复造射频链路:
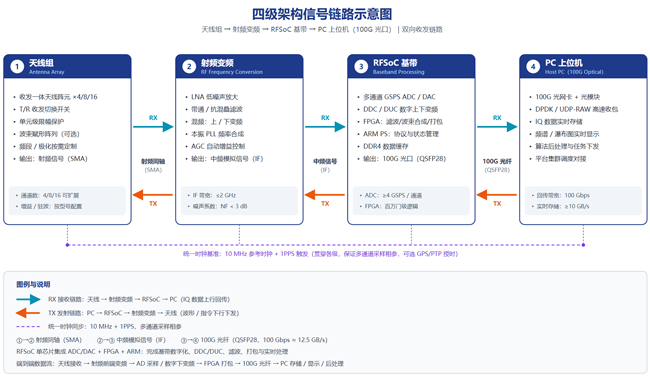
| 模块 | 关键指标 | 科研价值 |
|---|---|---|
| 8通道射频变频 | 0.2-18GHz / 中频1.3-2.3GHz / 瞬时带宽1GHz | 宽频段多通道阵列信号入口 |
| RFSOC 中频处理 | 8T8R / ADC≥2.5Gsps / 14bit / 100G光口 / 板载NVMe | 数字下变频、信道化、预处理在片上完成 |
| GPU核心模组(选配) | Jetson Orin NX 16GB | 边缘AI推理载体 |
| 上位机软件 | 配套软件 + 二次开发接口 | 算法注入与验证的主战场 |
四大功能闭环:频谱侦测(监测)→ 信号识别(AM/FM/SSB/FSK/MSK/BPSK/QPSK/8PSK/16QAM 调制识别;IFF/TACAN/数据链识别解调;雷达PRI抖动/滑变/参差、频率捷变等分选)→ 空间谱测向/干涉仪测向(超分辨)→ 干扰样式生成(按识别结果匹配调制样式)→ IQ采集存储闭环复盘。
二、核心算法解析:套件里跑的和你要研发的
2.1 链路级算法(RFSOC/FPGA 侧,套件已集成)
数字下变频(DDC)、多相滤波信道化(channelizer)、CFAR 恒虚警检测、脉冲描述字(PDW)提取——这些在 RFSoC 的 PL 逻辑中实时完成,属于"买来的能力"。
2.2 科研主攻算法(PC 侧,开放接口注入)
| 算法 | 原理 | 计算特征 | 硬件消耗点 |
|---|---|---|---|
| 调制识别(传统) | 瞬时特征(瞬时幅度/频率/相位)+ 决策树 | 轻量,可实时 | CPU即可 |
| 调制识别(DL) | CNN/ResNet 时频图分类、Transformer | 训练吃GPU、推理轻量 | 开发机24G+显存 |
| 空间谱测向 MUSIC/ESPRIT | 协方差特征分解 + 谱峰搜索 | 阵列×快拍平方级,内存带宽敏感 | 高频多核 + 大内存 |
| Capon/MVDR 波束 | 自适应权值求解 | 矩阵求逆,中等 | 多核CPU |
| 干涉仪测向 | 相位差查表/解模糊 | 实时性好 | FPGA/嵌入式 |
| 雷达信号分选 | 直方图(SDIF/CDIF)+ PRI 变换 + 脉内特征聚类 | 高密度脉冲流,数据并行 | 多核 + 大内存 |
| 干扰样式生成 | 噪声调频/梳状/灵巧样式参数化合成 | 计算轻、实时性硬 | RFSOC DAC链路 |
2.3 系统级闭环
识别结果 → 干扰决策 → 样式生成 → 效果评估的闭环,本质是多算法模块的实时调度问题——这也是二次开发接口存在的意义。
三、计算特点与算力瓶颈:一笔必须算清的数据账
| 环节 | 数据规模/特点 | 瓶颈 | 配置要点 |
|---|---|---|---|
| 原始IQ采集 | 8ch × 2.5Gsps × 14bit ≈ 35GB/s(≈126TB/小时) | 板载NVMe写带宽与容量 | 套件侧解决,选购时关注盘容量 |
| 光口传输 | 100Gbps = 12.5GB/s < 原始流 | 架构性瓶颈:只能传降速/抽取后数据 | 上位机网卡与驱动优化(DPDK) |
| 上位机实时分析 | 抽取后流 + 检测/识别/测向 | CPU单线程延迟 + 内存带宽 | 高频多核 + 128GB起 |
| 离线大数据回放 | TB级IQ文件批量算法验证 | NVMe阵列吞吐 + 内存 | 4TB NVMe起步、可扩展 |
| DL算法开发 | 时频图数据集构建 + 模型训练 | GPU显存与算力 | 24~48G显卡 |
关键洞察:科研效率的天花板往往不在套件,而在"采了一小时数据、回放分析要三天"——离线分析平台的存储吞吐与CPU性能,直接决定论文产出速度。
四、应用场景矩阵
| 场景 | 科研任务 | 算力画像 |
|---|---|---|
| 高校电子对抗/通信工程实验室 | 测向算法教学、毕业设计、竞赛 | 高频多核上位机 + 24G显卡 |
| 科研院所原型验证 | 新识别算法注入、闭环联调 | 大内存 + 低延迟IO工作站 |
| 雷达信号处理课题组 | 分选识别算法、脉内特征分析 | 多核 + NVMe阵列 |
| AI+信号处理交叉团队 | DL调制识别、波形智能生成 | GPU开发机 + 边缘部署模组 |
| 多阵元扩展研究 | 8通道以上阵列扩展、分布式同步 | 双路多PCIe + 40G/100G网络 |
五、UltraLAB硬件配置怎么选(三层算力对号入座)
5.1 上位机/联调工作站(实时分析 + 二次开发)
| 推荐机型 | 核心配置 | 适用 | 参考价 |
|---|---|---|---|
| A350156128-MCX | 24核(8P核5.5GHz)/ 128GB / RTX5070Ti 16G / 4TB NVMe | 上位机联调、调制识别开发 | ¥52,000 |
| A35015396-MCT | 锐龙9950X3D 16核 / RTX 5090D 32G 水冷 | 实时分析 + DL识别算法开发 | ¥89,990 |
| GT430P15164-MCX | Xeon W7-2475X 20核5.1GHz / RTX5080 | 算法验证 + 信号处理 + AI辅助 | ¥92,000 |
选型逻辑:上位机的硬指标是单核高频(检测/识别链路延迟敏感)+ 大内存(IQ段驻留分析)+ 一块够用的GPU(算法原型训练)。
5.2 离线大数据分析平台(TB级IQ回放、批量算法验证)
| 推荐机型 | 核心配置 | 适用 | 参考价 |
|---|---|---|---|
| GR450P15128-MCX | 撕裂者7980X 64核5.0GHz / 192GB / 大NVMe | 批量算法验证、MUSIC大规模谱搜索 | ¥145,000 |
| AE450 9654-MCX | EPYC 9654 96核3.55GHz / 128GB 水冷 | 多通道并行回放处理 | ¥99,990 |
| EA660 234512-MCX | 双路9654 192核 / 512GB | 课题组共享数据底座 | ¥255,000 |
5.3 网络与扩展(100G光口对接、多套件汇聚)
| 推荐机型 | 核心配置 | 适用 |
|---|---|---|
| EX660 229512-MCD | 双路Xeon / 40G以太网 / 大内存 | 多节点数据汇聚、低延迟分发 |
| 定制100G网卡方案 | PCIe5.0 ×16 + 100G NIC + DPDK调优 | RFSOC光口直连接收降速流 |
注意:100G光口满带宽接收需端到端调优(网卡offload、DPDK用户态驱动、NUMA绑核)——这正是 UltraLAB"算法级调优"交付服务覆盖的内容。
六、软件清单(科研套件配套环境预装建议)
| 类别 | 软件 |
|---|---|
| 操作系统 | Ubuntu 22.04 LTS(RFSOC工具链友好)、Windows 11 双系统 |
| RFSOC/FPGA工具链 | AMD/Xilinx Vitis、RFDC API、PYNQ(Python on Zynq) |
| SDR与信号处理 | GNU Radio、Python(NumPy/SciPy/Numba)、MATLAB + Phased Array/Communication Toolbox |
| 测向算法 | 自研MUSIC/ESPRIT/Capon、开源阵列信号库(如pyroomacoustics参考实现) |
| 分选识别 | 脉冲流仿真生成器、SDIF/CDIF参考实现、TorchSig 数据集 |
| AI开发 | PyTorch、CUDA/cuDNN、TensorRT(边缘部署Jetson)、ONNX Runtime |
| 网络高性能 | DPDK、 VMA/libvma、 iperf3 链路压测 |
| 数据管理 | 分段IQ文件格式(SigMF标准)、MinIO对象存储、Conda环境 |
七、FAQ:硬件配置深度分析
Q1:套件标称8×2.5Gsps,我的电脑能直接全速接收吗?不能,也不必。原始流约35GB/s,100G光口理论12.5GB/s——所有此类架构都是"板上预处理+降速传输":RFSOC完成DDC/信道化后,仅将检测数据、抽取IQ或关注频段送出。购机时让供应商演示"光口实际持续吞吐",并按该数字的1.5倍预留上位机IO能力。
Q2:IQ数据存一个小时要多少空间?怎么配存储?约 126TB/小时(8ch满速原始流)。实际按抽取比下降1~2个数量级。建议:热数据 4TB NVMe(回放分析用,顺序读7GB/s级),归档 8TB SATA + 课题组NAS;长期项目直接上大容量服务器(EA660 系列可扩展 20TB SATA 阵列)。
Q3:MUSIC测向8通道规模,PC能实时跑吗?8元阵、快拍数1024量级,单次MUSIC谱搜索(0.5°步进)在5GHz级CPU上单次耗时毫秒级——准实时可行;若做宽带聚焦/多频段联合测向,计算量倍增,建议RFSOC侧做降维预处理,PC侧专注谱搜索。矩阵库务必链接 MKL/BLAS 并开多线程。
Q4:DL调制识别模型最后要部署到哪?开发机怎么选?典型路径:PC端PyTorch训练(RTX 5090D 24~32G显存,batch宽松)→ 导出ONNX/TensorRT → 量化下沉到套件选配的 Jetson Orin NX 16G。开发机显存决定你能训多大的模型、放多大的batch——16G显存开发机训出来的模型往往要砍结构才能塞进边缘模组,建议一步到位上24G+。
Q5:一台上位机带得动多套件吗?光口汇聚场景下,双路平台的多PCIe通道数与内存带宽是关键:单路桌面平台跑满一张100G网卡已接近PCIe与内存带宽极限;多套件汇聚请直接选 EX660/EA660 双路线,并做NUMA绑核与DPDK调优。
Q6:水冷对这种联调环境有什么实际意义?算法联调经常连续数天抓数分析,满载风冷机降频会导致检测链路丢帧、时间戳漂移——数据"缺帧"对科研是致命的。全水冷保证7×24满血,且实验室噪音可控,学生工位可同屋部署。
结语:套件买的是入口,算力决定产出
科研套件把"从天线到基带"的工程门槛降到了最低,但算法的验证速度、数据的回放效率、模型的迭代周期,全部押在上位机与离线平台的算力上。UltraLAB 支持远程测试、按数据流实测选型、100G链路调优交付——把你的采集参数发给我们,先算清数据账,再配机器。


