






导读:纳卡冲突中 TB-2 与巡飞弹造成亚美尼亚 69.3% 的装备损失;俄乌战场上 FPV 无人机月投入量达数万架、光纤制导一周即被复刻并叠加 AI 末端制导;红海危机中 2000 美元的无人机迫使美军消耗 210 万美元的拦截弹,成本交换比高达 1:200~1:400。这些战例指向同一个结论:无人攻防能力已成为战斗力生成的核心变量,而传统训练体系存在"低端重复、高端缺失、训战脱节"三大痛点。
《无人作战军事仿真模拟推演训练与实战红蓝对抗演训场建设方案研究报告》给出的答案是"数字孪生+虚实融合+智能蓝军"三位一体演训系统。这套系统的每一层都是计算密集型的——本文拆解其核心算法与计算特点,给出 UltraLAB 硬件选型方法论。
一、体系拆解:三位一体演训系统的计算负载总览
| 组成部分 | 层次 | 核心功能 | 计算特征关键词 |
|---|---|---|---|
| 仿真推演训练场 | 战略战役层 | 大规模兵力推演、体系对抗评估 | 万级实体并行、CPU密集 |
| 战术分队层 | 蜂群协同、有人-无人协同科目 | 实时仿真、多节点联网 | |
| 单装操作层 | FPV操作、巡飞弹发射等模拟训练 | VR渲染、低延迟交互 | |
| 实战红蓝对抗演训场 | 环境构设 | 电磁干扰、防空威胁、城市地形全要素 | 射频仿真、场景生成 |
| 智能蓝军 | 像敌对手的无人蜂群、电子战压制 | AI训练与推理、行为决策 | |
| 数据闭环评估体系 | 全流程 | 以训促战、以战验训的数据闭环 | 海量数据吞吐、评估建模 |
二、主要核心算法与计算特点
2.1 数字孪生战场环境建模 —— 数据与渲染双密集
报告技术主线之首。数字孪生平台将物理空间的环境、事件、实体、关系映射为孪生体,支撑环境孪生模型与兵力孪生模型:
| 算法模块 | 技术实质 | 计算特点 | 硬件瓶颈 |
|---|---|---|---|
| 多图层地理建模 | 水系/道路/POI/影像多层GIS数据融合 | 图层叠加与坐标变换,内存驻留大 | 大内存 + 高速NVMe |
| 电磁环境孪生 | 干扰压制、频谱态势的动态生成 | 与电磁波传播模型耦合 | CPU多核 |
| 精细场景渲染 | 城市地形、目标外观三维重建 | 图形密集,多通道视景 | GPU渲染集群 |
| 孪生数据同步 | 实装遥测流↔孪生体状态融合 | 毫秒级时延约束,时钟同步敏感 | 高主频实时节点 |
2.2 装备建模与实时仿真 —— 百架级实体的并行世界
| 算法模块 | 技术实质 | 计算特点 | 硬件瓶颈 |
|---|---|---|---|
| 无人机6-DOF动力学 | 固定步长方程积分(100Hz~1kHz) | 实时确定性,核心数=可仿真实体数 | CPU核心数 |
| 数据链/电磁链路仿真 | 干扰压制、断链、GPS欺骗的链路级建模 | 状态机密集,并行度高 | CPU多核 + 低延迟网络 |
| 传感器模型 | 光电/红外/雷达探测概率建模 | 查表+概率计算,中等负载 | 高主频 |
| CGF行为引擎 | 路径规划(A*)、行为树决策 | 百级实体行为逻辑并行 | CPU多核 + 内存带宽 |
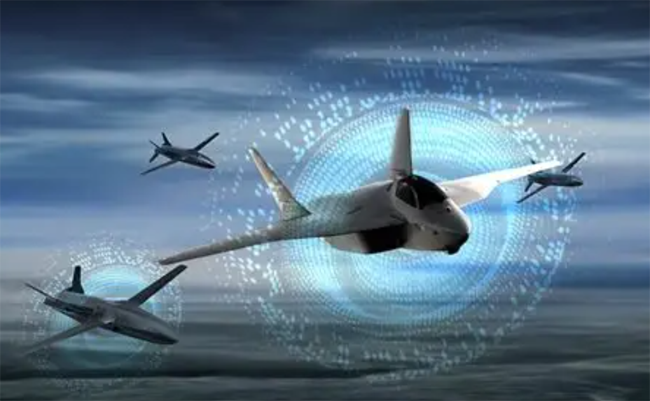
蜂群仿真是极限考验:复制者计划目标是数千套可消耗自主系统,演训系统需要支撑数百架级蜂群的实时推演——每架无人机的动力学、链路、行为逻辑独立运行,这是典型的"CPU核心数即规模"负载。
2.3 智能蓝军 —— 高水平对手的AI生产线
报告明确指出"没有像敌的蓝军,训练成绩必然虚高"。智能蓝军的技术路线与硬件需求:
| 技术路线 | 算法 | 计算特点 | 硬件需求 |
|---|---|---|---|
| 行为树蓝军(确定性) | 预置战术行为逻辑 | 推演时CPU多核,无GPU依赖 | CPU密集 |
| 强化学习蓝军(进化型) | PPO/MADDPG多智能体训练 | GPU训练重负载,需海量对抗样本 | 2~4× 48GB GPU |
| AI末端制导模型 | 机器视觉目标检测(YOLO类)训练 | 标注数据 + 模型训练 | GPU + 大存储 |
| 蓝军推演推理 | RL策略网络前向传播 | 轻量,可实时嵌入推演 | 单卡即可 |
推荐架构:行为树保证实时推演确定性,RL蓝军离线训练、定期进化——光纤无人机从实战到被复刻仅用一周,蓝军模型必须以周/月为周期滚动更新,GPU训练节点是刚需。
2.4 七大运用模式推演引擎 —— 想定生成与成本评估
报告归纳的七大模式(察打一体、诱饵消耗、蜂群饱和、跨域协同、无人+电子战、AI自主末端、纵深渗透特种打击)构成想定库的模式基元。推演引擎的计算核心:
| 算法模块 | 计算特点 |
|---|---|
| 想定生成与规则引擎 | 规则密集、事件驱动,CPU高主频 |
| 交战裁决(蒙特卡洛) | 大批量并行抽样,核心数敏感 |
| 成本交换比评估 | 毁伤×成本双维统计,报告将其列为第一标尺 |
| 时间压缩推演 | 数十倍实时加速,CPU并行度决定压缩比 |
2.5 反无体系闭环仿真 —— 探测-识别-处置-评估
| 环节 | 算法 | 计算特点 | 硬件瓶颈 |
|---|---|---|---|
| 探测 | 雷达低慢小目标检测、射频侦测定位 | 信号处理+AI检测 | GPU推理 |
| 识别 | 光电/红外 AI 辅助识别、多源融合 | 深度学习推理密集 | GPU显存 |
| 处置 | 干扰/诱骗/激光/微波/弹炮效能建模 | 效应模型蒙特卡洛 | CPU多核 |
| 评估 | 拦截成本、体系效能量化 | 统计分析 + 数据密集 | 内存+存储 |
2.6 数据闭环与评估体系 —— 被低估的存储怪兽
"以训促战、以战验训"要求演训全程数据资产化:一次蜂群级对抗推演产生的全量状态数据(数百实体×小时级×高频采样)轻松达到 TB 级,复盘评估需要高内存做时序聚合、NVMe 阵列做高速读取。
三、UltraLAB 硬件配置怎么选
3.1 按建设阶段分档
| 档位 | 定位 | CPU | GPU | 内存 | 存储 | 适用对象 |
|---|---|---|---|---|---|---|
| 方案 U1(单装训练) | FPV模拟器、VR单装操作训练 | 16核 高主频 | 1× RTX 5090 32GB | 128GB DDR5 ECC | 2TB NVMe | 基层训练点、院校 |
| 方案 U2(分队推演) | 战术分队级蜂群协同推演 | 32~64核 高主频 | 2× 48GB 专业卡 | 256~512GB | 8TB NVMe RAID | 合成营/训练中心 |
| 方案 U3(智能蓝军训练) | RL蓝军+视觉模型训练 | 32核 | 4× 48GB(多智能体并行训练) | 512GB | 16TB 数据盘 | 蓝军研发实验室 |
| 方案 U4(战役推演枢纽) | 战略战役级万实体推演 | 双路 64核 | 2× 48GB(渲染+AI) | 1TB | 全闪阵列 | 演训基地导调中心 |
| 方案 U5(外场机动) | 实兵对抗演训随行计算 | 16核 高主频 加固 | 1× 24GB 半高卡 | 128GB | 8TB 抗振NVMe | 外场试验/演习分队 |
3.2 选型要点解读
-
蜂群仿真先数核心:数百实体实时推演的扩展公式很简单——每 4
8 核支撑一个高保真实体。U2 的 64 核意味着约 816 架高保真无人机或数百架简化实体,规划时先算账再上卡。 - 蓝军训练与蓝军推演是两台机器:RL 训练是离线批处理(多卡 GPU 昼夜跑),推演是实时在线(CPU 密集 + 轻推理)。U3 管进化,U2/U4 管对抗,混用必互相拖慢。
- 虚实融合节点必须高主频 + 硬时钟:实装接入的遥测融合环路是毫秒级闭环,硬件时间戳与实时Linux是地基,普通服务器做不了。
- 评估体系的存储要按"每次推演 TB 级"规划:数据闭环不是口号,是持续增长的存储账单——U4 的全闪阵列按 3 年推演数据量规划。
四、软件清单:无人演训体系的完整技术栈
4.1 仿真引擎与建模层
| 层 | 软件/标准 | 用途 |
|---|---|---|
| 分布式仿真 | HLA(IEEE 1516)+ RTI、DIS(IEEE 1278) | 多节点虚实互联、LVC融合 |
| 飞行动力学 | MATLAB/Simulink、Gazebo/JSBSim | 无人机6-DOF与链路建模 |
| 战场环境 | 数字孪生平台 + GIS引擎(Cesium/自研) | 环境/兵力孪生模型 |
| 电磁环境 | 自研干扰与频谱态势生成模块 | 电磁对抗构设 |
4.2 智能蓝军与AI层
| 层 | 软件 | 用途 |
|---|---|---|
| 多智能体RL | PyTorch + PettingZoo/MARLlib(PPO/MADDPG) | 蓝军进化训练 |
| 行为引擎 | BehaviorTree.CPP + 自研战术库 | 确定性蓝军与实体行为 |
| 视觉制导 | YOLOv8/RT-DETR + TensorRT | AI末端制导模型训练与部署 |
| 想定引擎 | 自研规则引擎 + 蒙特卡洛裁决 | 七大模式想定生成与推演 |
4.3 数据闭环层
| 层 | 软件 | 用途 |
|---|---|---|
| 数据采集 | 全量状态记录器 + 反射内存网 | 推演数据零丢失 |
| 评估分析 | 自研评估模型(毁伤×成本双维)+ ParaView | 复盘评估(AAR) |
| 数据底座 | TimescaleDB + MinIO/CEPH | 时序数据+对象存储 |
4.4 交互展现层
| 层 | 软件 | 用途 |
|---|---|---|
| 态势显示 | 自研二维/三维态势系统(OpenGL/Vulkan) | 指挥所大屏 |
| VR/AR训练 | OpenXR + Unity/Unreal | 单装操作与沉浸式科目 |
| 复盘回放 | 三维航迹重建引擎 | 交战裁决可视化复盘 |
五、大模型本地部署:演训的"智能参谋"
演训数据与战法知识的敏感性决定大模型必须本地化。落地场景:想定文书生成、战法知识问答、自动复盘摘要、蓝军策略辅助设计。
5.1 模型规模与显存需求对照表
| 部署角色 | 推荐模型 | 参数规模 | INT4量化显存 | 推荐GPU配置 |
|---|---|---|---|---|
| 想定文书/课目生成 | Qwen3-32B | 32B | ~20GB | 单卡 24GB |
| 战法知识问答+长文复盘 | Qwen3-72B(128K上下文) | 70B+ | ~40GB+KV | 单卡 48GB |
| 多Agent参谋团(规划+评估+问答) | 72B × 2 实例 | 70B | ~80GB | 2× 48GB(96GB) |
| 多模态战例解析(视频/图像) | Qwen2.5-VL-72B | 70B+ | ~40GB | 单卡 48GB |
| 团队中枢 | Qwen3-235B-A22B | 235B | ~120GB | 2× 96GB / 4× 48GB |
5.2 推荐部署栈
- 推理引擎:vLLM(并发参谋实例)/ Ollama(外场便携节点)
- RAG:全球战例库(纳卡/俄乌/红海等公开案例)、装备手册、训练大纲向量化——报告要求"课目更新以周、月为周期滚动迭代",大模型辅助想定改写正是提速工具
- Agent 编排:LangGraph 编排"战例检索→想定生成→推演对接"链路,对接推演引擎 API
- 安全底线:全链路离线,演训数据不出内网
六、典型应用场景与配置速查
| 应用场景 | 核心负载 | 推荐方案 | 预算区间 |
|---|---|---|---|
| 院校无人机操作教学 | VR训练 + 轻推演 | U1 × N | 入门 |
| 合成营蜂群协同推演室 | 百级实体实时推演 | U2 | 中高 |
| 智能蓝军研发实验室 | RL多智能体训练 | U3 | 高 |
| 训练基地红蓝对抗中心 | 环境构设+导调+评估 | U2 + U4 | 旗舰 |
| 外场实兵对抗演习保障 | 机动计算+数据采集 | U5 集群 | 中高 |
| 反无体系效能评估平台 | 探测识别AI+蒙特卡洛 | U2 + 本地大模型 | 中高 |
七、常见问题:硬件配置深度分析
Q1:蜂群级仿真(数百架无人机)的第一硬件瓶颈是什么?
A:CPU核心数与内存带宽,不是GPU。 每个仿真实体独立运行动力学积分、链路状态机和行为决策,是天然的并行负载——推演规模直接等于核心数除以单实体开销。GPU 只在两个环节有用:AI末端制导模型的训练(离线)和态势渲染(U4 的多屏大屏)。把钱全堆在GPU上而配了个16核CPU,是蜂群仿真最常见的选型事故。
Q2:智能蓝军选行为树还是强化学习?硬件差多少?
A:两个都要,但管不同的事——行为树管实时推演,RL管离线进化。 行为树蓝军零GPU依赖、确定可控、可解释,适合嵌入实时推演环路;RL蓝军训练是多智能体GPU重负载(MADDPG类算法需4×48GB级节点昼夜跑),但训练出的策略网络推理时轻如鸿毛。报告的"周级迭代"要求(光纤无人机一周被复刻)只有"RL离线进化+行为树在线执行"的混合架构能满足。
Q3:虚实融合演训为什么对时延如此敏感?
A:因为实装与虚拟世界共享同一个时钟。 实装无人机的遥测位置与虚拟防空火力的命中判定,必须在毫秒级统一时空基准下融合——时延抖动直接导致"虚拟导弹命中延迟判定"或"虚实战果错位",训练评估就失真了。这类节点需要高主频CPU、硬件时间戳卡、实时Linux与反射内存网,普通虚拟化服务器做不到。
Q4:RL蓝军训练为什么推荐多卡48GB而不是单卡96GB?
A:多智能体训练的本质是并行环境采样。 MADDPG/MAPPO的瓶颈常在环境 rollout 的吞吐而非单步计算——4×48GB 可以并行跑4组独立实验(不同对手模型/不同超参),实验迭代速度是单卡的数倍;且单卡96GB在多数RL框架下无法被单个实验吃满。U3 的多卡架构是按"并行实验数"设计的,不是按"单实验规模"。
Q5:数据闭环体系为什么按"每次推演TB级"规划存储?
A:全量状态记录是评估可信度的前提。 报告的"以战验训"要求复盘能回答任意交战细节——这意味着数百实体×小时级×10Hz以上的全量状态落盘,一次蜂群推演即 TB 级。更关键的是读取模式:复盘评估是随机时间窗检索,不是顺序扫描,SATA 盘的随机性能会让一次复盘等几个小时。U4 的全闪阵列不是奢侈,是评估效率的基础设施。
Q6:已有通用服务器机房,演训节点还需要专用工作站吗?
A:需要,实时负载与交互负载必须贴身处。 蜂群推演的实时闭环、VR训练的低延迟渲染、导调台的交互态势——跨机房执行的每一毫秒延迟都在破坏训练有效性;机房放 U3 训练队列与数据仓库,训练现场放 U2/U4 实时节点与 U1 工位,万兆/反射内存网互联,是报告"三位一体"在硬件拓扑上的对应实现。
写在最后
报告给出的六条结论——环境构设全要素、对手建设高水平、评估指标含成本、课目更新快节奏、训练层次完整、攻防能力一体化——每一条背后都是一条计算流水线:全要素环境需要数字孪生的数据处理能力,高水平对手需要智能蓝军的训练算力,成本评估需要蒙特卡洛的并行吞吐,快节奏迭代需要AI辅助的想定生产线。
战场环境建模拼数据与渲染,蜂群推演拼CPU核心数,智能蓝军拼GPU训练集群,虚实融合拼实时性,数据闭环拼存储吞吐——无人演训没有单点捷径,只有体系化的算力底座。
UltraLAB 以"高主频实时节点 + 多核推演节点 + GPU训练集群 + 全闪数据底座 + 加固机动节点"的全谱系矩阵,为三位一体演训系统提供从单装训练到战役推演的全层次算力。当无人攻防的迭代周期已经缩短到一周,算力底座的响应速度,就是训练体系的迭代速度。
© 2026 UltraLAB 解决方案团队 | 本文基于公开研究报告《无人作战军事仿真模拟推演训练与实战红蓝对抗演训场建设方案研究报告》的技术框架分析撰写,文中战例数据均引自公开报道,配置方案为通用参考,具体型号与报价请联系 UltraLAB 官方获取定制化方案。


