摘要:OPM Flow 是兼容 Eclipse 输入格式的开源全隐式黑油模拟器,已在实际油田运营中使用,并完成 1.01 亿网格的 CO₂ 储存大规模并行演示。本文结合 GPU 求解器系统评测(单 GPU 最高加速单 MPI 进程 5.6 倍)与 SPE11 基准,分析"线性求解主导、内存带宽受限"的负载结构,给出 UltraLAB 工作站分档选型。
适用读者:油藏工程师、CCUS 与地下储能研究人员;需要无许可成本运行 Eclipse 格式模型的油气与科研机构。
资料背景与核心观点
资料名称:《An Evaluation and Comparison of GPU Hardware and Solver Libraries for Accelerating the OPM Flow Reservoir Simulator》(arXiv:2309.11488,2023/2025 修订);SINTEF《Open Porous Media (OPM)》软件介绍(sintef.no,2026-11 更新);SPE11 CO₂ 储存基准中的 OPM Flow 说明(arXiv:2507.15861)。
发布机构:SINTEF、NORCE、OPM-OP 及 Equinor 等组成的 OPM 社区;GPU 评测来自挪威高校/研究机构。
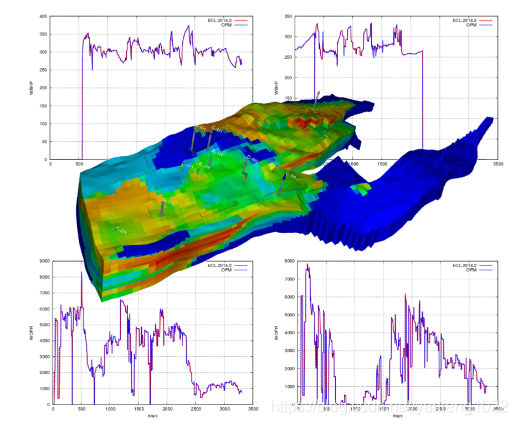
核心观点:OPM Flow 模拟含溶解气/挥发油的黑油模型,支持毛管力与相渗曲线、端点标定与滞后等,输入兼容 Eclipse、输出可被商业后处理(含自家 ResInsight)读取;SINTEF 明确其"为商业用途开发、已在多个资产运营中使用",并演示了 SPE11 Case C 的 1.01 亿网格大规模并行。GPU 评测给出关键数据:迭代线性求解器占据主要计算时间;在 NORNE(约 5 万活动网格)到 100 万活动网格的用例上,单张 GPU 可使单个双线程 MPI 进程加速最高 5.6 倍,约相当于 8 个双线程 MPI 进程——这为"工作站 + 单卡"替代"小集群"提供了量化依据。
主要功能模块与核心算法
- 流体模型:三相(水/油/气)三组分黑油,溶解气与挥发油;CO₂ 储存专用 CO2STORE 选项(CO₂-盐水 PVT)。
- 离散与求解:全隐式有限体积,自动微分组装雅可比;非线性 Newton + 线性迭代求解(默认 DUNE ISTL 的 BiCGStab + ILU0/CPR 类预条件)。
- 并行:MPI 域分解(默认 CPU 路径);GPU 路径通过 cuSparse、rocSparse、amgcl 或 OpenCL 自研求解器加速线性阶段。
- 井模型与调度:标准井控与历史拟合所需的生产/注入调度。
- 前后处理生态:Eclipse 格式输入;ResInsight 可视化;pyopmspe11 类脚本工具生成基准输入。
- 扩展物理:聚合物、溶剂注入、热采等扩展模型(按版本)。
计算特点与性能瓶颈
- 线性求解主导:迭代求解器占主要运行时间;SpMV 与不完整分解预条件都是内存带宽受限操作——CPU 路线的扩展性随带宽饱和而衰减。
- MPI 并行:单机数十核可用;百万网格级以上建议多节点或 GPU 卸载线性求解。
- GPU 加速条件明确但边界清晰:评测显示单 GPU 对单 MPI 进程最高 5.6×、约抵 8 个 MPI 进程;但预条件子(ILU0 的三角求解)在 GPU 上并行度有限,全 GPU 化不如"GPU 求解 + CPU 预条件/组装"的混合模式普遍有效。商业对照:Echelon 为全 GPU 方案(单卡上限约 1200 万活动网格),INTERSECT 提供 GPU 线性求解——说明行业共识是"线性求解器上卡"。
- 内存与显存:百万活动网格的全隐式系统需数十 GB;GPU 方案时显存需容纳矩阵与预条件结构,24 GB 级显卡对应百万网格量级。
- I/O:历史拟合多实现运行、重启文件与汇总输出,NVMe 数据盘为宜。
典型应用场景
- 油田开发方案对比:Eclipse 格式模型直接复用,数十万网格级在工作站 32 核上按天完成方案矩阵。
- CCUS 储存模拟:CO2STORE 模型参与 SPE11 基准;十万—百万网格级注入—盖层—羽流运移研究。
- 历史拟合与不确定度:数十至数百次实现批量运行,任务级并行 + 单机 GPU 线性求解卸载。
- 教学与方法研究:零许可成本替代商业黑油模拟器,配合 MRST/ResInsight 构成完整研究栈。
UltraLAB 硬件配置建议
油藏模拟的选型围绕"网格规模 → 求解器路径(CPU-MPI 或 GPU 卸载)":
| 档位 | CPU 选型思路 | 内存 | GPU 与显存 | 系统盘/数据盘 | 适用规模 |
|---|---|---|---|---|---|
| 入门档 | 16 核高内存带宽 CPU | 128 GB | 可选 1 张 24 GB GPU(GPU 求解器实验) | 1 TB NVMe + 2 TB 数据盘 | NORNE 级(数万活动网格)模型学习与调试 |
| 主流档 | 32 核 | 256 GB | 1 张 24 GB GPU(cuSparse/amgcl 混合求解) | 1 TB NVMe + 4 TB NVMe 数据盘 | 十万—百万活动网格、方案对比与历史拟合 |
| 高性能档 | 64 核或双路 | 512 GB—1 TB | 1—2 张 48 GB 级 GPU | 2 TB NVMe + 8 TB 数据盘 | 百万—千万网格、CCUS 多实现批量 |
要点:CPU 路线优先内存带宽(通道插满);GPU 路线的收益集中在迭代求解阶段,预条件子与雅可比组装仍在 CPU,故单卡 + 强 CPU 优于多卡。显存按"活动网格数 × 每格状态量"估算,百万网格级建议 24 GB 起步。GPU 求解器路径需在编译时启用对应后端,部署前核对所用 OPM 版本的求解器支持矩阵。
软件清单
| 类别 | 软件/工具 | 必需性 | 说明 |
|---|---|---|---|
| 模拟器 | OPM Flow | 必需 | 全隐式黑油/CO₂ 储存 |
| 求解器后端 | DUNE ISTL(默认)、cuSparse/rocSparse/amgcl(GPU 可选) | 按需 | 线性与非线性求解 |
| 前后处理 | ResInsight | 建议 | 结果可视化 |
| 输入兼容 | Eclipse 格式数据体 | 必需 | 模型复用 |
| 脚本 | Python(pyopmspe11 等)、Jupyter | 可选 | 基准与批量驱动 |
常见问题
Q1:OPM Flow 能替代 Eclipse 吗?
输入输出格式兼容,SINTEF 称其已用于多个资产的运营,研究用途与方案预筛选完全可行;关键商业决策通常仍需与商业模拟器交叉验证。
Q2:GPU 到底能快多少?
系统评测(NORNE 至 100 万网格)显示:单 GPU 对单 MPI 进程最高 5.6 倍加速,约相当于 8 个 MPI 进程。收益集中在迭代线性求解,非全流程等比加速。
Q3:百万网格需要多少内存?
全隐式 + CPR/ILU 类预条件下,CPU 路线建议 256 GB 以上;GPU 路线显存 24 GB 可覆盖百万网格量级,矩阵与预条件结构超限时会回落到 CPU 或失败,需实测。
Q4:CO₂ 储存模拟和油藏开发模拟硬件需求一样吗?
负载结构相同(全隐式 + 迭代求解);CO2STORE 的两相两组分体系未知量更少,同等网格下内存略省,但长时尺度模拟的时间步数更多,总耗时可能更高。
Q5:双路 CPU 还是单路 + GPU?
评测数据支持"单路强 CPU + 单 GPU 混合求解"的性价比:GPU 承担 SpMV 密集部分,CPU 承担组装与预条件。双路 CPU 适合纯 CPU 路线或内存容量优先场景。
总结与选型建议
OPM Flow 的选型围绕线性求解器展开:CPU-MPI 路线买带宽,GPU 路线买单卡显存 + 强 CPU 的组合。入门者 16 核 + 128 GB 可复现 NORNE 级公开模型;主流生产研究 32 核 + 256 GB + 24 GB 单卡是甜区;CCUS 大规模与批量历史拟合按 512 GB+ 内存与 48 GB 级显存规划。零许可成本 + Eclipse 格式兼容使其成为油藏与 CCUS 研究的高性价比底座。
参考来源
- Nane R. et al. An Evaluation and Comparison of GPU Hardware and Solver Libraries for Accelerating the OPM Flow Reservoir Simulator. https://arxiv.org/abs/2309.11488
- SINTEF. Open Porous Media (OPM). https://www.sintef.no/en/software/open-porous-media-opm/
- SPE11 基准研究(OPM Flow CO2STORE 说明). https://arxiv.org/pdf/2507.15861
- OPM 官方网站. https://opm-project.org/
上述所有配置,代表最新硬件架构,同时保证是最完美,最快,如有不符,可直接退货
欲咨询机器处理速度如何、技术咨询、索取详细技术方案,提供远程测试,请联系
UltraLAB图形工作站供货商:
西安坤隆计算机科技有限公司
国内知名高端定制图形工作站厂家
业务电话:400-705-6800
咨询微信号:100369800