






——盘点2025年AI+CAE十大科研突破与UltraLAB硬件配置方案
当西北工业大学的"秦岭·翱翔"大模型以秒级速度重构高超声速流场,当中科院的PDE-Agent让不懂编程的科研人员仅凭自然语言就能求解Navier-Stokes方程,当MIT的多智能体框架实现从草图到CFD云图的全自动无人干预——AI+CAE已从概念验证迈入科研实用化拐点。
本文基于AIE共进社盘点的国内外前沿科研项目,深度解析AI+CAE三大主流技术路线的计算特征与硬件需求,为高校实验室与科研机构的智能仿真平台建设提供参考。
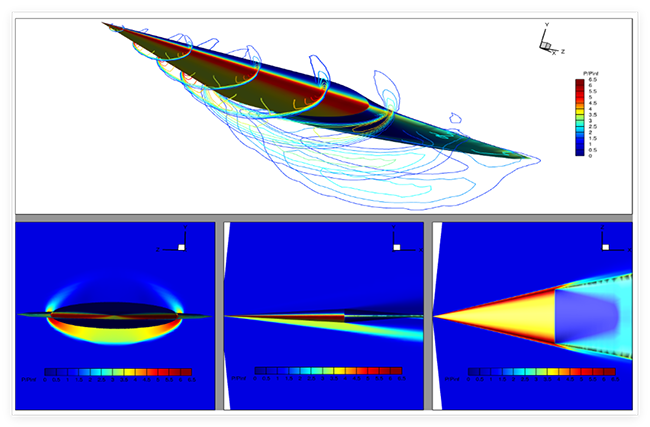
一、AI+CAE三大科研主攻方向与代表项目
当前AI+CAE科研领域呈现"三足鼎立"格局,分别对应代理模型降阶、AI求解PDE、多智能体自治三大范式:
方向1:AI代理模型(Surrogate Model)——高保真仿真的实时化替代
核心逻辑:用深度神经网络(FNO、DeepONet、U-Net)学习传统CFD/FEA的输入-输出映射,将小时级的数值求解压缩至秒级推理,同时保持工程精度。
代表项目:
| 项目名称 | 机构 | 技术亮点 | 应用场景 |
|---|---|---|---|
| 秦岭·翱翔 | 西工大+华为AI4Sci Lab | 面向飞行器的流体力学大模型,AI湍流模型全替代传统PDE,流场预测端到端 | 高雷诺数湍流、全速域气动仿真 |
| 汽车风阻智能预测 | 武汉理工大学 | 基于点云的自研模型,预测精度2.9%,参数化模型精度5% | 整车空气动力学快速评估 |
| DNN-MG | 德国埃尔穆特·施密特大学+西门子 | 深度神经网络多重网格求解器,粗网格经典求解+细网格神经网络修正 | 非稳态NS方程加速 |
| SHIFT-SUV | Luminary+丰田+英伟达 | 首个开源汽车空气动力学AI模型与数据集 | 汽车外形设计优化 |
计算特征:
-
训练阶段:需要TB级高保真仿真数据(如Stanford BlastNet数据集14TB),涉及高斯过程、FNO算子学习,显存需求极大(24GB-80GB)
-
推理阶段:前向传播计算密集,Tensor Core加速显著,单卡RTX 4090可实现毫秒级流场预测
-
数据预处理:千万级网格的体素化、点云化,内存带宽敏感
方向2:AI求解偏微分方程(AI for PDE)——科学计算的范式革命
核心逻辑:用物理信息神经网络(PINN)、傅里叶神经算子(FNO)等方法直接学习PDE的解算子,或让大语言模型(LLM)自动生成求解代码。
代表项目:
| 项目名称 | 机构 | 技术亮点 | 求解能力 |
|---|---|---|---|
| PDE-Agent | 中科院自动化所 | 多智能体协作(Planner+Solver+Executor+Orchestrator),Prog-Act双循环纠错 | 热方程、波动方程、NS方程等,PDE-Bench成功率90% |
| PINNsAgent | 北京大学 | 物理引导知识重放(PGKR)+记忆树推理(MTRS),自动生成最优PINN架构 | 自主探索PINN架构,无需深度学习专家 |
| RealPDEBench | 西湖大学+上海交大等 | 真实物理实验数据(PIV/化学发光)与仿真数据配对,系统评估模型真实场景表现 | 圆柱绕流、流固耦合、燃烧等5类场景 |
| PhysicsX | PhysicsX团队 | 从底层几何表示入手,破解AI CAE代理模型训练挑战 | 多物理场统一表示学习 |
计算特征:
-
PINN训练:自动微分(AD)计算图构建复杂,需要高显存GPU(48GB+)支撑大规模PDE残差约束
-
多智能体协作:LLM(如GPT-4、Llama3)本地部署需大内存(128GB+)与多卡推理
-
知识重放与记忆树:强化学习策略迭代,CPU多核并行与GPU混合计算
方向3:多智能体自治仿真(Agentic CAE)——从需求到云图的全无人化
核心逻辑:基于LLM的多智能体系统(Multi-Agent)自主分解任务,调用CAD、网格、求解、后处理工具,实现"一句话需求,全自动仿真"。
代表项目:
| 项目名称 | 机构 | 智能体分工 | 自治能力 |
|---|---|---|---|
| AI CFD Agent | MIT | Styling Agent→CAD Agent→Meshing Agent→Simulation Agent | 汽车设计→建模→仿真→优化全流程,纯自然语言输入 |
| MetaOpenFOAM | 清华大学 | Architect(架构师)+InputWriter+Runner+Reviewer | OpenFOAM自动配置、错误自纠错、RAG知识增强 |
| ChatCFD | OpenFOAM官方 | 知识库检索+案例文件生成+执行错误反思 | 端到端OpenFOAM自动化,支持论文上传自动配置 |
| OpenfoamGPT 2.0 | 英国埃克塞特大学 | 前处理Agent→Prompt生成Agent→仿真引擎→后处理Agent | 近500个案例100%一次成功,批量处理上百Case,出版级出图 |
计算特征:
-
LLM推理延迟敏感:7B-70B参数模型本地部署,需AI推理卡(如A100/H100)或高端消费级GPU
-
多工具链调用:CAD(SolidWorks/Rhino)+网格(Pointwise/Gmsh)+求解器(OpenFOAM/ANSYS)并行,多核CPU+大内存(256GB+)保障流畅切换
-
AutoML架构搜索:PINN架构优化、超参数调优,GPU并行计算必需
二、AI+CAE科研软件工具矩阵
| 技术环节 | 开源/科研工具 | 商业软件 | AI框架 |
|---|---|---|---|
| 数据生成 | OpenFOAM, SU2, FEniCS | ANSYS Fluent, Abaqus, Star CCM+ | - |
| 代理模型训练 | FNO(GitHub官方), DeepONet, U-Net, ResNet | Neural Concept, PhysicsX | PyTorch, JAX, PaddlePaddle |
| PINN求解 | DeepXDE, NeuroDiffEq, SimNet | - | PyTorch, TensorFlow |
| 多智能体框架 | LangChain, AutoGen, MetaGPT | - | OpenAI API, Llama3, Qwen |
| 基准数据集 | BlastNet(Stanford), RealPDEBench, PDE-Bench, SHIFT-SUV | - | Hugging Face Datasets |
| 可视化评估 | ParaView, Matplotlib, Tecplot | - | TensorBoard, Weights&Biases |
三、UltraLAB AI+CAE科研工作站硬件配置方案
基于上述项目的计算特征,UltraLAB推出针对AI+CAE科研的三级硬件配置方案:
【方案S】流体力学大模型训练站(秦岭·翱翔级)
适用场景:大模型预训练、TB级数据集处理、FNO/DeepONet算子学习
推荐机型 UltraLAB GR450P
| 组件 | 配置规格 | 技术价值 |
|---|---|---|
| GPU | NVIDIA RTX 5090 32GB ×4 或 A100 80GB ×2 | 支撑FNO大模型并行训练,显存容量应对千万级网格场数据 |
| CPU | AMD Threadripper 9995WX (96核) 或 Intel Xeon 698X (68核) | 数据预处理与后处理多核并行 |
| 内存 | 512GB DDR5-4800 ECC | 加载14TB级数据集(BlastNet)的样本缓存 |
| 存储 | 30TB NVMe SSD (10TB×3 RAID0) + 100TB HDD冷存 | 高保真仿真数据高速读写与归档 |
| 网络 | 双万兆以太网 | 分布式训练节点间高速同步 |
| 软件栈 | 预装PyTorch 2.0+、JAX、PaddlePaddle、DeepXDE、FNO库 | 开箱即用 |
【方案M】多智能体自治开发站(MetaOpenFOAM级)
适用场景:LLM驱动的CAE Agent开发、PINN架构搜索、多物理场耦合
推荐机型 UltraLAB AX430
| 组件 | 配置规格 | 技术价值 |
|---|---|---|
| GPU | RTX Pro 5000 48GB | 本地部署Llama3-70B或Qwen-72B大模型,支撑Agent推理 |
| CPU | Intel Xeon 8592+ (64核),单核睿频5.2GHz | 保障OpenFOAM等传统求解器单任务性能 |
| 内存 | 256GB DDR5-4800 ECC | 支撑多智能体并发与大型LLM模型加载(70B参数约需140GB+) |
| 存储 | 8TB NVMe SSD + 32TB RAID5 | 仿真案例库与RAG知识库存储 |
| 特色功能 | 预装LangChain、AutoGen、OpenFOAM、Docker | 快速部署Multi-Agent环境 |
【方案L】AI代理模型推理站(汽车风阻预测级)
适用场景:代理模型实时推理、设计空间探索、参数化优化
推荐机型 UltraLAB GT450P
| 组件 | 配置规格 | 技术价值 |
|---|---|---|
| GPU | RTX 5080 16GB 或 RTX 5090D v2 24GB | 毫秒级流场预测,Tensor Core加速推理 |
| CPU | Intel Xeon 696X (64核) 全核超频4.5GHz | 保障传统CFD对比验证时的求解速度 |
| 内存 | 128GB DDR5-5600 | 支撑批量推理任务并发 |
| 存储 | 4TB NVMe SSD | 快速加载预训练模型权重 |
| 显示器 | 32英寸 4K 专业色彩显示器 | 流场可视化与对比分析 |
四、关键趋势:AI+CAE科研对算力基础设施的新要求
-
显存容量成为硬门槛:FNO、DeepONet等算子学习需将整个流场作为张量处理,24GB显存是入门,48-80GB才是科研常态。
-
混合架构成主流:传统CFD(CPU密集)+ AI训练(GPU密集)+ LLM推理(显存+带宽敏感)三类负载需在同一工作站共存,要求硬件配置无短板。
-
存储带宽瓶颈凸显:Stanford BlastNet 14TB、RealPDEBench 700+轨迹数据集,要求NVMe SSD阵列保障数据 pipeline 不堵塞。
-
多智能体需本地LLM:调用OpenAI API存在数据安全与延迟问题,70B级大模型本地部署成为高校实验室刚需,对内存容量(256GB+)与GPU显存提出双重要求。
从西工大的"秦岭·翱翔"到清华的MetaOpenFOAM,从MIT的AI CFD Agent到中科院的PDE-Agent,AI+CAE科研正经历从"算法创新"到"工程实用"的关键跃迁。
在这场智能仿真的范式革命中,算力基建不再是背景板,而是决定科研突破速度的核心变量。UltraLAB深度适配AI+CAE三大技术路线的计算特征,以"大显存、高内存、全闪存"的硬核配置,为高校与科研机构的智能仿真平台建设提供坚实底座。
让每一次Agent协作都流畅无阻,让每一个PINN收敛都事半功倍——UltraLAB,与AI+CAE科研同行。
本文技术框架引用自AIE共进社《国内外AI+CAE部分科研项目盘点》及相关论文
UltraLAB图形工作站供货商:
西安坤隆计算机科技有限公司
国内知名高端定制图形工作站厂家
业务电话:400-705-6800
咨询微信号:100369800



