






——当材料科学遇上多尺度计算仿真,一台高性能工作站如何支撑从原子到整机的航空发动机研发?
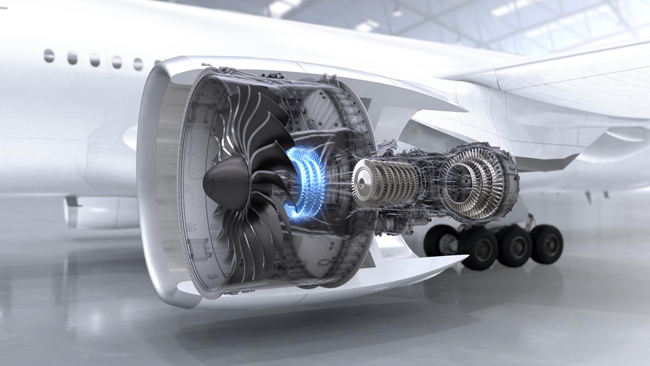
一、项目背景:单晶涡轮叶片,航空发动机的"皇冠明珠"
航空发动机被誉为"现代工业皇冠上的明珠",而单晶涡轮叶片则是"明珠上镶钻"——它工作在1500℃以上的超高温、高压、高转速、腐蚀性燃气冲刷的极端环境中,直接决定发动机的推力、油耗、可靠性与寿命。
中国航发北京航空材料研究院李嘉荣团队历时数十年攻关,成功研制出具有自主知识产权的第二代单晶高温合金DD6,性能达到或优于欧美同代产品,已成为我国应用量最大的单晶高温合金。这一突破不仅填补了国内空白,更标志着我国在航空发动机核心材料领域从"跟跑"迈向"并跑、局部领跑"。
但鲜为人知的是,在这项"国之重器"背后,从合金成分设计、定向凝固铸造、晶体生长控制到服役性能评估,每一个环节都离不开大规模、多尺度的计算仿真支撑。对于从事航空材料、高温合金、精密铸造研究的教授、博士和工程师而言,算力底座直接决定了研发效率与精度上限。
二、主要技术环节拆解:单晶叶片研制的"计算仿真全图谱"
单晶涡轮叶片从合金熔炼到成品交付,全程涉及十余个核心大工序,而每个工序背后都对应着特定的计算仿真需求:
2.1 合金成分设计与热力学计算(宏观设计层)
技术环节:在Ni基体中精准配比Cr、Al、Co、W、Mo、Re、Ta等多种合金元素,实现高温强度、抗蠕变、抗氧化、抗热腐蚀的最优平衡。
核心算法:
-
CALPHAD方法(Calculation of Phase Diagrams):基于热力学数据库计算多元合金相图
-
吉布斯自由能最小化:预测凝固路径、析出相种类与含量
-
机器学习势函数(MLIP):替代传统经验势,提升多元素体系预测精度
计算特点:数据库查询密集 + 非线性优化迭代,单任务计算量不大但需大量参数扫描(成分空间探索),适合多任务并行。
2.2 第一性原理计算(原子尺度层)
技术环节:揭示合金元素的电子结构、晶体缺陷形成能、固溶强化机制、层错能等基础物理量。
核心算法:
-
密度泛函理论(DFT):VASP、CASTEP、Quantum ESPRESSO
-
广义梯度近似(GGA)/ 杂化泛函:计算力学性能、弹性常数
-
NEB(Nudged Elastic Band):扩散激活能垒计算
计算特点:CPU密集型,矩阵对角化(Kohn-Sham方程)消耗大量内存;支持k点并行,多核扩展性好;部分代码支持GPU加速(VASP 6.4+ CUDA)。
2.3 分子动力学模拟(纳米尺度层)
技术环节:模拟高温下位错运动、晶界滑移、蠕变变形、辐照损伤等动态过程。
核心算法:
-
嵌入式原子法(EAM)/ 修正嵌入原子法(MEAM):描述金属体系相互作用
-
深度势能(Deep Potential, DeePMD-kit):基于机器学习的势函数,精度接近DFT、速度接近MD
-
NPT/NVT系综:高温高压下的结构演化
计算特点:高度并行,邻居列表搜索 + 力计算适合GPU加速;大规模体系(百万原子)需要大显存 + 高显存带宽;DeePMD-kit 训练阶段需GPU,推理阶段可CPU/GPU混合。
2.4 定向凝固与铸造工艺仿真(介观-宏观层)
技术环节:模拟熔体充型、温度场分布、枝晶竞争生长、缩孔缩松预测、型壳-合金交互作用。
核心算法:
-
有限体积法(FVM):ProCAST、MAGMA、FLOW-3D 求解流动-传热-凝固耦合
-
相场法(Phase Field):MICRESS、OpenPhase 模拟枝晶形貌演化
-
元胞自动机(CA):追踪晶粒取向选择、竞争生长过程
计算特点:
-
铸造CFD:瞬态求解,时间步长小,网格量大(千万级),内存需求高,CPU多核并行
-
相场模拟:大规模稀疏矩阵求解,内存密集型,对内存带宽敏感
-
CA法:规则网格上的局部更新,适合GPU并行加速
2.5 涡轮叶片结构强度与热机械疲劳(宏观工程层)
技术环节:评估叶片在高温、离心载荷、气动载荷、热梯度下的应力应变、蠕变寿命、低周疲劳。
核心算法:
-
有限元法(FEM):ANSYS Mechanical、Abaqus、MSC Nastran
-
粘塑性本构模型:Chaboche、Garofalo 蠕变方程
-
扩展有限元(XFEM):裂纹萌生扩展预测
-
流固耦合(FSI):Fluent + Mechanical 耦合,模拟气热弹耦合
计算特点:
-
亿级网格 + 非线性材料 + 多物理场耦合 = 内存黑洞
-
显式动力学(冲击、鸟撞)需要高主频CPU
-
隐式非线性求解(蠕变、疲劳)需要大内存 + 多核并行
2.6 多尺度耦合与数字孪生(系统整合层)
技术环节:将原子尺度的缺陷信息传递到介观组织,再映射到宏观性能,构建"成分-工艺-组织-性能"全链条预测。
核心算法:
-
FE² 多尺度法:宏观有限元每个积分点嵌入微观RVE
-
数据驱动代理模型:神经网络替代部分物理求解器,加速设计迭代
-
数字孪生框架:实时映射叶片服役状态
计算特点:多任务并发 + 异构计算,CPU负责宏观求解,GPU负责微观MD/DFT代理模型,需要大内存缓存中间结果。
三、计算负载画像:CPU、GPU、内存、存储如何分工?
表格
| 仿真环节 | CPU角色 | GPU角色 | 内存需求 | 存储I/O | 典型耗时 |
|---|---|---|---|---|---|
| 热力学计算 | 多核并行优化 | 无 | 32~64GB | 中 | 分钟级 |
| DFT第一性原理 | 核心计算 | 部分加速 | 64~256GB | 低 | 小时~天 |
| 分子动力学 | 辅助 | 主力加速 | 128~512GB | 中 | 小时~天 |
| 铸造CFD | 主力 | 可选 | 256GB~1TB | 高(网格/结果文件大) | 小时~天 |
| 相场模拟 | 主力 | 可选 | 512GB~2TB | 高 | 天~周 |
| 结构有限元 | 主力 | 可选 | 256GB~1TB | 中 | 小时~天 |
| 多尺度耦合 | 宏观求解 | 微观代理 | 1TB+ | 极高 | 周级 |
关键洞察:
-
内存是瓶颈:相场、大规模有限元、多尺度耦合极易吃满512GB甚至1TB内存
-
GPU是加速器:MD、部分DFT、CA法、代理模型训练需要GPU,但铸造CFD和宏观FEM仍以CPU为主
-
存储不能省:一个完整的涡轮叶片多物理场仿真项目,网格文件+结果文件轻松上TB,且需要频繁随机读取
四、核心软件工具链清单
表格
| 技术环节 | 推荐软件 | 授权类型 | 硬件偏好 |
|---|---|---|---|
| 热力学/相图 | Thermo-Calc, Pandat, FactSage | 商业 | CPU多核,64GB内存 |
| 第一性原理 | VASP, CASTEP, Materials Studio, Quantum ESPRESSO | 商业/开源 | CPU高主频+大内存;VASP 6.4+支持GPU |
| 分子动力学 | LAMMPS, GROMACS, DeePMD-kit | 开源 | GPU加速(CUDA),大显存 |
| 铸造工艺 | ProCAST, MAGMA, FLOW-3D, AnyCasting | 商业 | CPU多核,大内存,高速存储 |
| 相场/微观组织 | MICRESS, OpenPhase, 自研PF代码 | 商业/自研 | 大内存,高内存带宽 |
| 结构力学 | ANSYS Mechanical, Abaqus, MSC Nastran | 商业 | CPU多核+大内存;Abaqus支持GPU |
| CFD/流固耦合 | ANSYS Fluent, CFX, OpenFOAM | 商业/开源 | CPU多核,大内存,高速存储 |
| 多尺度/AI代理 | PyTorch/TensorFlow + 自研耦合框架 | 开源 | GPU训练,CPU推理,大内存 |
五、硬件配置推荐:面向航空材料多尺度仿真的 UltraLAB 图形工作站方案
方案 A:单卡旗舰型 —— 材料计算课题组主力工作站
定位:覆盖DFT→MD→铸造CFD→结构FEA全链条,单用户深度计算。
表格
| 组件 | 配置规格 | 选型逻辑 |
|---|---|---|
| CPU | Intel Xeon W7-3465X (28C56T, 4.8GHz, 64PCIe) 或 AMD Threadripper PRO 7995WX (96C192T) | DFT/FEA需要高主频+多核并行;W-3400系列支持4TB内存扩展,适合相场大内存需求 |
| 内存 | 512GB DDR5-4800 RDIMM (8×64GB) | 支撑千万级网格铸造CFD + 百万原子MD + 大规模FEA同时驻留 |
| GPU | NVIDIA RTX Pro 6000 96GB ×1 | 96GB显存跑大规模MD(DeePMD-kit训练)无压力;Blackwell架构Tensor Core加速AI代理模型训练 |
| 系统盘 | 2TB NVMe Gen5 SSD | 系统+软件快速启动 |
| 数据盘 | 8TB NVMe U.2 SSD ×2 | 铸造CFD/FEA结果文件动辄数百GB,双盘RAID 0持续读取>7GB/s |
| 阵列卡 | LSI MegaRAID 9670W-16i | 支撑多路U.2 NVMe直连,未来可扩展至全闪存阵列 |
| 电源 | 1600W钛金 | RTX Pro 6000峰值功耗+CPU超频余量 |
| 散热 | CPU 360mm水冷+机箱风道优化 | 长时间DFT/MD计算稳定性 |
| 系统 | Ubuntu 22.04 LTS + 统信UOS双系统 | 科研软件生态+国产自主可控双保险 |
相关机型:UltraLAB AX430
方案 B:双卡均衡型 —— 航空发动机研究所多任务并行平台
定位:支持2~3人同时使用,DFT/MD与铸造CFD/FEA并行不冲突。
表格
| 组件 | 配置规格 | 选型逻辑 |
|---|---|---|
| CPU | 2× Intel Xeon 6530 (2×32C64T, 160MB L3) | 双路服务器级,内存通道翻倍,I/O调度更强;64核应对多任务并发 |
| 内存 | 1TB DDR5-4800 RDIMM (16×64GB) | 相场模拟+多尺度耦合的内存安全垫;双路CPU内存通道全插满 |
| GPU | NVIDIA RTX Pro 6000 96GB ×2 | 双卡可并行跑两套MD任务,或单卡训练AI代理模型、单卡推理 |
| 系统盘 | 2TB NVMe Gen5 SSD | 双路平台配Gen5,消除I/O瓶颈 |
| 数据盘 | 8TB NVMe U.2 SSD ×4 | 课题组多项目数据安全+并发读取,总容量32TB |
| 阵列卡 | 8口 NVME RAID卡 | 32口NVMe直连,未来扩展全闪存阵列 |
| 网络 | 10GbE双口 | 组内数据共享、远程提交任务 |
| 电源 | 2000W | 双GPU+双路CPU峰值功耗,冗余保障 |
| 机箱 | 4U机架式/塔式转换 | 可进机房也可放办公室 |
相关机型:UltraLAB GT660M
方案 C:多卡集群型 —— 航材院/高校航空发动机仿真中心
定位:支撑"成分-工艺-组织-性能"全链条多尺度计算,嵌入航空发动机数字孪生流程。
表格
| 组件 | 配置规格 | 选型逻辑 |
|---|---|---|
| CPU | 2× AMD EPYC 9684X (2×96C192T, 1GB L3) | 192核应对多用户并发+大规模并行DFT;3D V-Cache加速内存密集型相场/FEA |
| 内存 | 2TB DDR5-4800 RDIMM | 多用户多任务,每用户分配256~512GB;支撑亿级网格FEA |
| GPU | NVIDIA H100 96GB ×4 | H100 NVLink四卡互联,大规模MD+AI代理模型训练;B200单卡192GB显存直接翻倍单任务上限 |
| 存储 | 全闪存阵列:15.36TB U.2 NVMe ×8 (RAID 5) | 企业级数据安全+超高并发I/O;总容量~100TB,支撑数字孪生海量数据 |
| 网络 | 100GbE / InfiniBand NDR | 多节点扩展、模型参数同步、数字孪生实时数据流 |
| 系统 | Ubuntu 22.04 + Slurm作业调度 + Docker容器化 | 多用户排队调度,CAE/DFT/MD软件容器化部署 |
相关机型:UltraLAB GA668
六、选型关键决策点:航空材料仿真容易被忽视的三个细节
6.1 内存容量 > CPU核心数
相场模拟和亿级网格有限元的瓶颈往往不是核不够,而是内存不够。一个三维相场模型,500³网格单精度浮点就是4GB,加上历史场、辅助场、矩阵预处理器,轻松突破128GB。512GB是底线,1TB才宽裕。
6.2 GPU显存决定MD规模上限
用DeePMD-kit训练高温合金势函数,体系越大、元素越多,显存消耗越惊人。RTX Pro 6000 96GB可以支撑百万原子级体系训练,而48GB卡可能只能跑一半规模。显存即体系规模。
6.3 铸造CFD是"I/O黑洞"
ProCAST/MAGMA一个完整算例,中间结果文件可能达数百GB,且需要频繁写入。如果存储是机械盘或低速SATA SSD,求解器会大量时间花在等I/O上。U.2 NVMe阵列不是奢侈,是刚需。
七、结语:算力底座支撑材料强国梦
从DD6单晶高温合金的自主研制,到复合气冷与双层壁超冷单晶涡轮叶片的关键技术突破,中国航发航材院的成就证明:航空发动机的核心竞争力,既在实验室的坩埚里,也在计算仿真的代码里。
对于从事高温合金、精密铸造、航空发动机设计的科研团队而言,一台配置合理的高性能图形工作站——大内存支撑相场与有限元,强CPU支撑DFT与CFD,大显存GPU支撑分子动力学与AI代理模型,高速NVMe阵列支撑海量数据吞吐——就是缩短研发周期、降低试错成本、追赶国际先进水平的最硬底气。
UltraLAB 定制图形工作站,基于 Xeon W-3400 / 双路 EPYC 9004 / Threadripper PRO 平台,搭配 RTX Pro 6000 / H100 / B200 全系列 GPU,提供从单卡桌面到多卡集群的航空材料多尺度仿真算力方案。支持 Ubuntu/国产系统双系统、预装 VASP/LAMMPS/Fluent/Abaqus 环境,开箱即用。
UltraLAB图形工作站供货商:
西安坤隆计算机科技有限公司
国内知名高端定制图形工作站厂家
业务电话:400-705-6800
咨询微信号:100369800


