






导语:2026 年 9 月,德国军工巨头莱茵金属(Rheinmetall)做了一件打破行业惯例的事——把自家 Battlesuite 数字作战平台的首批核心接口规范正式开源:负责单车内部组件通信的 OnboardAPI 与面向多平台战术数据交互的 TacticalAPI,以 EPL-2.0 协议放上 GitHub。这家以 RH-120 坦克炮闻名的百年防务集团,正在用开源接口推动"软件定义装备"。而对更广泛的开发者与科研团队来说,真正的机会在于:这套沉淀自真实装备项目的工业级中间件设计,加上 AI 大模型的决策能力,正在把高保真数字孪生仿真的门槛拉到一台工作站的水平。
一、热点回顾与 AI 分析:军工开源背后的技术信号
1.1 事件速览
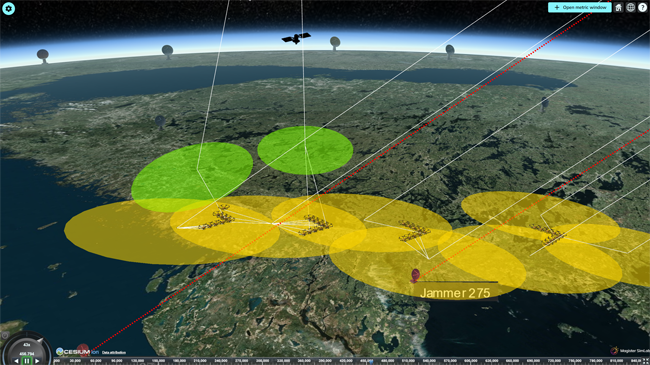
莱茵金属将其作战系统通信中间件接口对外开源:OnboardAPI 定义了分布式模块化架构的标准化数据模型(基于自研 ddkit 框架),覆盖传感器网络、车载通信层、机器人系统、嵌入式分布式架构约 50 个功能模块(告警、摄像头、激光测距、转塔控制、任务控制等);TacticalAPI 则提供 gRPC 接口访问态势感知系统,用于跨平台数据追踪、可视化与分析。官方明确其目标是降低不同厂商装备的数据集成难度,同一套架构还可用于民防、灾害管理与关键基础设施防护。
1.2 AI 视角的深度解读
| 维度 | 分析 |
|---|---|
| 架构信号 | "软件定义装备"已成为全球防务主流叙事,装备能力通过软件迭代而非重新设计获得——这与汽车行业的"软件定义汽车"同构 |
| 技术资产 | 开源的不是玩具代码,而是经过真实装备验证的数据模型规范 + QoS 策略 + 版本兼容机制(XTypes/XCDR2),其价值远超代码本身 |
| AI 拐点 | 标准化数据接口 + 高保真仿真环境 = AI 决策模型的训练场:无人系统的强化学习、多智能体协同、传感器融合算法,都需要这样的"数字靶场" |
| 隐私刚需 | 防务、应急、关键基础设施数据高度敏感,仿真数据与 AI 模型必须完全本地化——本地部署是唯一选项 |
关键洞察:DDS 中间件本体是延迟敏感的实时计算负载,而 AI 仿真训练是吞吐敏感的 GPU 负载——数字孪生工作流是"双模算力"的典型代表,硬件选型必须同时满足"实时性"与"训练吞吐"两个互相矛盾的目标。
二、核心算法解析:DDS 中间件是如何工作的
2.1 发布订阅通信模型(相对传统 C/S 的革命)
传统客户端-服务器模式要求双方事先知道彼此地址;DDS 采用以数据为中心的发布订阅(Publish-Subscribe):组件无需知道对方在哪,通过网络的发现阶段(Discovery)自动匹配——就像广播电台与听众,频率对上了数据自然流动。OnboardAPI 基于 OMG DDS 标准构建,底层采用 Eclipse CycloneDDS 实现。
2.2 八类操作与可靠性策略(工业级 QoS 设计)
| 接口 | 操作 | 说明 | 交付保证 | 迟加入支持 |
|---|---|---|---|---|
| IService | Cmd | 客户端命令服务 | 可靠 | 否 |
| IService | Config | 客户端配置服务 | 可靠 | 是 |
| IService | Notify | 客户端向服务更新数据 | 可靠 | 否 |
| IService | Request | 客户端向服务发起请求 | 可靠 | 否 |
| IClient | Report | 向所有客户端共享状态报告 | 可靠 | 是 |
| IClient | Event | 向所有客户端广播数据事件 | 可靠 | 否 |
| IClient | Response | 对请求的应答 | 可靠 | 否 |
| IClient | Stream | 流式数据传输 | 尽力而为 | 否 |
| 机制 | 算法原理 | 工程价值 |
|---|---|---|
| 迟加入支持(Late-Joiner) | 库自动缓存最后发送的值,晚上线的组件立即获得最新状态 | 战场网络组件异时启动也不会"错过一切" |
| 键控主题(Keyed Topics) | 每个唯一键作为独立数据流管理生命周期,配合 IsRemoved 标志 | 每个目标的来去状态系统一清二楚 |
| 版本兼容 | DDS XTypes 类型系统 + XCDR2 序列化编码 | 新旧版本软件同车共存多年,通信不断裂 |
| 无线组网 | 组播仅用于参与者发现(SPDP),数据与端点发现(SEDP)走单播 | 规避 WiFi 组播不可靠问题 |
| 防火墙穿透 | 纯单播 Peers 列表模式 | 云端/公网/防火墙环境通信路径完全可控 |
2.3 AI 增强层(仿真与决策)
| 技术 | 代表工具 | 说明 |
|---|---|---|
| 高保真传感器仿真 | CARLA / AirSim / Gazebo | 生成带标注的相机、激光雷达、雷达合成数据,训练融合感知模型 |
| 多智能体强化学习 | RLlib / PettingZoo + PyTorch | 多无人平台协同策略训练,需大规模并行环境 |
| 决策大模型 | 本地部署 LLM(如 Qwen3-32B/72B) | 态势报告自然语言化、任务规划辅助、仿真复盘分析 |
| 数字孪生同步 | DDS + ROS 2 桥接 | 仿真世界与真实装备数据流同构,训练成果可直接迁移 |
三、计算特点分析:实时性与吞吐量的双重挑战
3.1 DDS 中间件本体的计算画像
| 特征 | 表现 | 硬件含义 |
|---|---|---|
| 延迟敏感性 | 车载/机器人控制回路要求毫秒级确定性延迟 | 高主频 CPU + 实时内核/CPU 隔离 |
| 单核性能 | 序列化/反序列化(XCDR2)、QoS 状态机多为单线程热路径 | 5.0+ GHz 主频收益显著 |
| 网络栈 | 高频小数据包收发,DPDK/内核旁路可进一步降延迟 | 万兆网卡起步,25GbE 更佳 |
| 内存 | 键控主题缓存 + 历史样本缓存 | 128 GB ECC 起步 |
| GPU 需求 | 本体为零 | 但仿真渲染与 AI 训练全靠 GPU |
3.2 AI 仿真训练的计算画像
| 负载类型 | 特征 | 硬件侧重 |
|---|---|---|
| 传感器融合感知训练 | 大规模点云/图像 batch、高显存占用 | 大显存 GPU(48 GB 级) |
| 强化学习(多环境并行) | CPU 上并行跑数十上百个仿真实例 + GPU 推理 | 高核心数 CPU + GPU 配比 1:1~2:1 |
| 高保真实时渲染 | 数字孪生可视化、HIL 回灌 | RTX 系列光追能力 |
| 决策大模型推理 | 32B~70B 量化推理 + KV Cache | 40 GB+ 显存 |
结论:这是一个 "高频 CPU 保实时 + 多核 CPU 跑仿真集群 + 大显存 GPU 训模型" 的三重负载。单台工作站想兼顾数字孪生开发与 AI 训练,必须在这三者间精平衡。
四、应用场景:从军工到民用的"数字孪生靶场"
| 场景 | 工作流描述 | 算力侧重点 |
|---|---|---|
| 无人系统研发(无人机/机器人/无人车) | 遵循 OnboardAPI 规范开发组件 + 仿真环境训练控制策略 | 高频 CPU + 中等 GPU |
| 高校科研 / 教学实验 | DDS 中间件研究、多智能体协同算法、ROS 2 课程 | 入门单卡方案 |
| 应急管理与灾害推演 | TacticalAPI 态势数据接入 + 数字孪生推演 + AI 预案生成 | 大显存 GPU(70B 模型)+ 高内存 |
| 关键基础设施防护仿真 | 工业园区/电网数字孪生 + 传感器融合异常检测训练 | 多卡训练 + 大容量 NVMe |
| 智能驾驶算法验证 | CARLA 高保真场景 + DDS 车载中间件同构验证 | GPU 渲染 + 并行仿真核心数 |
| 车联网/路侧协同 | 多节点 DDS 组网协议验证(纯单播/无线模式) | 多网口 + 高频 CPU |
五、软件清单:从中间件到 AI 仿真全栈
5.1 通信中间件层
| 类别 | 软件 | 用途说明 |
|---|---|---|
| 接口规范 | OnboardAPI / TacticalAPI(Rheinmetall 官方仓库) | 参考数据模型与 QoS 设计,EPL-2.0 许可 |
| DDS 实现 | Eclipse CycloneDDS | OnboardAPI 官方底层实现,cyclonedds.xml 配置组网 |
| 机器人中间件 | ROS 2(Humble/Jazzy) | 同为 DDS 架构,与 OnboardAPI 设计哲学互通 |
| 商用 DDS | RTI Connext / FastDDS | 跨厂商互操作性测试、生产环境备选 |
5.2 仿真与训练层
| 类别 | 软件 | 用途 |
|---|---|---|
| 物理仿真 | Gazebo / Isaac Sim | 机器人动力学与传感器仿真 |
| 自动驾驶仿真 | CARLA / AirSim | 高保真城市场景、合成数据生成 |
| 强化学习 | RLlib / CleanRL + PyTorch | 多智能体策略训练 |
| 可视化引擎 | Unreal Engine / Unity(AirSim/CARLA 底座) | 数字孪生高保真渲染 |
5.3 AI 推理与本地大模型层
| 类别 | 软件 | 用途 |
|---|---|---|
| 推理框架 | Ollama / vLLM | 本地部署 Qwen3-32B/72B 决策与复盘模型 |
| 多模态接入 | Xinference | 图像/文本统一推理服务 |
| RAG 知识库 | Qdrant + LangChain | 作战条例/应急预案检索增强 |
| 监控 | Prometheus + Grafana | 仿真节点与 GPU 状态监控 |
5.4 系统与环境层
| 类别 | 软件 | 用途 |
|---|---|---|
| 操作系统 | Ubuntu Server 22.04 LTS(PREEMPT_RT 实时补丁可选) | 确定性延迟保障 |
| 编译构建 | CMake + GCC/Clang(find_package(onboardapi) 标准集成) | C++ 组件开发 |
| 多语言绑定 | Python 3.13/3.14、Java、C# wrapper | 快速原型与算法验证 |
| 容器 | Docker + NVIDIA Container Toolkit | 仿真环境与推理服务隔离 |
六、大模型本地部署:敏感场景的"物理隔离"底线
6.1 为什么必须本地
防务推演数据、关键基础设施拓扑、应急预案、传感器实测数据——任何一类都涉及国家安全或商业机密,云端 API 在这一领域没有讨论空间。而数字孪生的价值恰恰在于用真实数据校准仿真,数据与模型必须同处一个物理隔离环境。
6.2 部署路径对比
| 方案 | 适用模型 | 优点 | 缺点 |
|---|---|---|---|
| Ollama | 7B~32B | 快速部署,仿真复盘单人可用 | 并发吞吐有限 |
| vLLM | 32B~70B | 多路仿真节点并发调用决策模型 | 调优门槛略高 |
| TensorRT-LLM | 量化推理 | 显存占用降 30%,时延更低 | 仅 NVIDIA,编译链路复杂 |
| TensorRT-LLM + 多实例 | 70B AWQ/FP8 | 单卡跑 70B,多仿真节点共享 | 需精细批调度 |
6.3 推荐模型组合
| 角色 | 模型 | 显存需求 |
|---|---|---|
| 态势研判/报告生成 | Qwen3-72B(量化) | 40~48 GB |
| 实时决策辅助 | Qwen3-32B | 20~24 GB |
| 视觉感知模型 | YOLO / BEVFusion(自训) | 8~16 GB |
| 知识库 Embedding | bge-m3 | 2~4 GB |
七、UltraLAB 硬件配置推荐(三档方案)
7.1 入门研发档:UltraLAB AR350 —— 个人开发者 / 高校实验室
| 部件 | 配置 |
|---|---|
| GPU | RTX 5090 32GB ×1 |
| CPU | AMD Ryzen 9 9950X(16 核,5.0+ GHz 高主频) |
| 内存 | 128GB DDR5 ECC |
| 存储 | 2TB NVMe ×2 + 10GbE 网卡 |
| 电源/散热 | 1200W 金牌 / 静音塔式 |
适合:OnboardAPI/ROS 2 组件开发、单机数字孪生 Demo、32B 决策模型推理、教学实验。
7.2 主力仿真档:UltraLAB AE450 —— 无人系统研发团队
| 部件 | 配置 |
|---|---|
| GPU | RTX 6000 Ada 48GB ×2(一卡渲染仿真 + 一卡 AI 训练) |
| CPU | AMD Threadripper 7970X(32 核,仿真实例并行 + 高主频) |
| 内存 | 256GB DDR5 ECC |
| 存储 | 2TB NVMe 系统盘 + 8TB NVMe 仿真数据集 + 25GbE 网卡 |
| 电源/散热 | 2000W 白金 / 工作站级风道 |
适合:CARLA/Isaac Sim 高保真仿真 + RLlib 并行训练、多节点 DDS 组网验证、72B 量化模型部署。
7.3 旗舰平台档:UltraLAB GE450 —— 数字孪生靶场 / 应急推演中心
| 部件 | 配置 |
|---|---|
| GPU | NVIDIA H100 80GB / RTX 6000 Ada 48GB ×4 |
| CPU | AMD Threadripper PRO 7995WX(96 核,百路仿真实例并行) |
| 内存 | 512GB DDR5 ECC 8 通道 |
| 存储 | 4TB NVMe + 60TB NVMe 全闪阵列(点云/图像数据集高 IOPS) |
| 网络 | 双 25GbE(DDS 数据平面与管理平面分离) |
| 电源/散热 | 双 2000W 冗余 / 4U 机架风道 |
适合:多智能体大规模强化学习、城市级数字孪生推演、多团队并发"数字靶场"平台。
八、常见问题:硬件配置深度分析
Q1:DDS 中间件不吃 GPU,为什么推荐配置里 GPU 占大头?
因为数字孪生工作流的价值在"仿真 + AI"闭环:CARLA/Isaac Sim 渲染靠 GPU,感知模型训练靠 GPU,决策大模型推理还是靠 GPU。DDS 只负责把数据按时送到——它是神经系统,但肌肉(仿真渲染)和大脑(AI 模型)全部依赖 GPU。只做中间件协议研究可以省掉 GPU;做数字孪生,GPU 就是第一预算项。
Q2:仿真节点并行到底吃 CPU 核心还是吃 GPU?
两者都要,比例是关键。 每个仿真实例(Gazebo/CARLA server)是独立进程,吃 CPU;实例中的相机/激光雷达渲染与神经网络推理才吃 GPU。经验配比:每路高保真仿真实例约占用 24 个 CPU 核 + 58 GB 显存。32 核 CPU 配单卡 48GB 可并行 68 路;96 核配 4 卡可并行 2432 路。只堆 GPU 不堆核,仿真实例排队等 CPU,训练吞吐照样上不去。
Q3:DDS 的实时性对硬件有什么特殊要求?
DDS 控制回路(如转塔伺服、无人车紧急避障)要求毫秒级确定性延迟,这会暴露普通工作站的两个短板:① 后台进程与中断抖动,需启用 CPU 隔离(isolcpus)、实时内核(PREEMPT_RT)或专用实时网卡;② 虚拟化与容器引入的额外延迟,关键控制链路应跑在裸机。UltraLAB 工作站支持出厂预装实时调优系统,省去自行调内核的数周时间。
Q4:数据集存储为什么强调全闪阵列而非大容量机械盘?
多智能体训练每轮迭代要读入海量点云与图像 batch,机械盘的随机 IOPS(约 200)会让 GPU 长时间空转等待数据——实测 GPU 利用率可能从 95% 跌到 40%。NVMe 全闪阵列提供百万级 IOPS,才能让 4 卡 H100 满血运行。仿真数据集增长极快(城市级 CARLA 场景 + 多传感器一天即可产生数 TB),建议 60TB 起步并预留扩展。
Q5:消费级游戏卡能否替代 RTX 6000 Ada 做仿真训练?
研发阶段可以,生产环境不建议:① 无 ECC 显存,长时间训练可能出现比特翻转导致模型权重静默损坏;② 多卡互联与驱动稳定性未按 7×24 满载设计;③ 商用 DDS 中间件(如 RTI)仅认证专业卡驱动。更现实的考量是折旧:旗舰平台 3 年使用周期内,因显存不足被迫换卡的成本远高于一步到位。
结语
从莱茵金属开源作战系统接口,到"软件定义装备"成为行业共识,标准化数据中间件 + AI 数字孪生正在重构装备研发范式:先在数字世界里训练千万次,再把成熟算法交给真实系统。而这套范式的底座,是一台既能跑实时 DDS 通信、又能扛高保真仿真、还能本地训练大模型的工作站——数据不出域,算力不外包。
合规声明:相关技术请仅在授权、合法及民用场景下研究与使用,遵守所在地法律法规。本文仅作技术研究与硬件选型讨论。
联系我们:UltraLAB 提供数字孪生/无人系统方向免费配置咨询与 7 天试用,回复"孪生"获取《DDS 中间件 × 本地大模型仿真部署白皮书》。


