






一、当芯片热到"烫手",仿真工程师在算些什么?
随着芯片集成度从纳米级向亚纳米级跃进,功率密度正以惊人的速度攀升。一颗指甲盖大小的功率模块,局部热流密度可达数百瓦每平方厘米——这比太阳表面的热流密度还要高。热管理,已从"锦上添花"变成了决定产品生死的"卡脖子"环节。
传统的"试错-打样-测试"循环,周期长、成本高,且往往只能发现"已经热了"的问题,而无法预判"哪里会先热"。基于COMSOL Multiphysics的多物理场耦合仿真,正是为解决这一痛点而生。它能在数字世界里,同时模拟电、热、流三种物理场的相互纠缠,让工程师在投产前就看透器件的"体温分布图"。
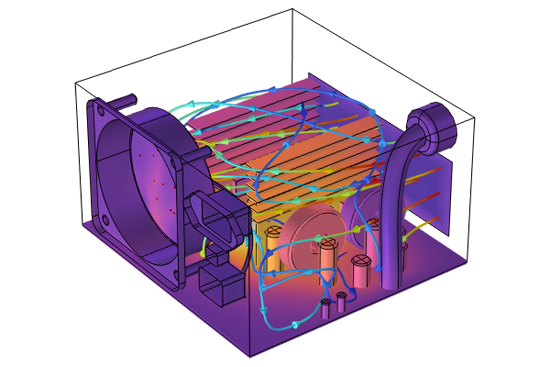
二、三大核心物理场与耦合算法
本案例针对一个典型的高功率密度电子封装结构(基板约30mm,含柱状热沉阵列),构建了固体传热+层流+静电场的全耦合模型。其背后涉及的核心算法与物理机制如下:
1. 固体传热(Solid Heat Transfer)
核心算法:基于能量守恒方程(傅里叶定律+对流/辐射边界),求解稳态或瞬态温度场分布。
∇⋅(k∇T)+Q=0
其中,k 为材料导热系数,Q 为体积热源功率。案例中,顶部封装区底面施加热源,基板下表面及侧面施加对流换热边界(对流系数 h=10 W/(m2⋅K) ,环境温度25°C)。
工程意义:直接输出芯片结温、热沉温度梯度、基板散热效率,是热设计的第一张"体检报告"。
2. 层流(Laminar Flow)
核心算法:求解不可压缩Navier-Stokes方程组(连续性方程+动量方程),描述冷却流体在器件周围的流动行为。
ρ(u⋅∇)u=−∇p+μ∇2u+ρg
案例中,在基板下方设置强制对流通道,入口速度 0.1 m/s ,出口压力释放,固体表面设为无滑移壁面。
工程意义:揭示流体在热沉间的分流、绕流、涡旋结构,评估风冷/液冷系统的实际散热能力。
3. 静电场(Electrostatics)
核心算法:求解电势泊松方程(欧姆定律的微分形式),得到电流密度与电势分布。
∇⋅(σ∇V)=0
其中,σ 为电导率(温度相关,即电热耦合的关键)。案例中,顶部电极施加电势边界,其余区域接地或浮动。
工程意义:定位电流集中路径与高电场区域,预判电迁移风险。
三、多物理场耦合:1+1+1 > 3 的奥秘
本案例的精髓不在于单独求解三个物理场,而在于捕捉它们之间的双向耦合:
表格
| 耦合类型 | 物理机制 | 数学表达 | ||
|---|---|---|---|---|
| 电热耦合(焦耳热) | 电流通过电阻产生焦耳热,温度升高又改变材料电导率 | $Q_{\text{Joule}} = \mathbf{J} \cdot \mathbf{E} = \sigma | \nabla V | ^2$ |
| 热-流耦合(浮力驱动) | 温度场引起流体密度变化(Boussinesq近似),产生浮力驱动自然对流;流体流动又带走热量改变温度分布 | ρ=ρ0[1−β(T−T0)] | ||
| 热-结构耦合(可扩展) | 温度变化导致热膨胀,产生热应力 | σ=D:(ε−εth) |
求解策略:采用全耦合(Fully Coupled)非线性求解器,通过自动牛顿法迭代,同时更新温度、速度、电势三个场变量,直至残差收敛。这种"强耦合"方式比顺序耦合(单向传递)精度更高,但计算代价也更大。
四、计算特点:为什么你的笔记本会"算不动"?
多物理场耦合仿真对硬件的"压榨"是全方位的:
-
非线性方程组规模巨大:三个物理场耦合后,自由度(DOF)数量是单场的3倍以上。一个中等精度的模型轻松达到数十万至数百万自由度。
-
迭代收敛困难:电热耦合中的焦耳热项、热-流耦合中的浮力项都引入强非线性,牛顿迭代可能需要数十甚至上百步才能收敛。
-
内存带宽敏感:每个迭代步都需要组装和求解大型稀疏矩阵,对内存容量和带宽要求极高。
-
网格质量决定精度:热沉与基板交界处、电极边缘等几何特征复杂区域需要局部加密,网格数量直接决定求解规模。
-
后处理数据量大:温度场、速度场、电势场的三维可视化,以及切面、流线、矢量图的实时渲染,对显卡显存和图形性能有较高要求。
五、硬件配置推荐:从"能算"到"算得快"
针对COMSOL多物理场耦合仿真的计算特点,推荐以下三类配置方案:
方案一:入门学习型
适合高校学生、初级工程师进行中小规模(<50万自由度)的二维或简单三维模型学习。
表格
| 组件 | 推荐配置 |
|---|---|
| CPU | Intel Core i7-14700K / AMD Ryzen 7 7700X(8P+12E核 / 8核16线程,高主频利于前处理与网格划分) |
| 内存 | 64GB DDR5-5600(双通道,COMSOL对内存容量极其敏感,32GB在耦合场中容易吃紧) |
| 存储 | 1TB NVMe SSD(PCIe 4.0,快速加载模型与保存结果) |
| 显卡 | RTX 4060 Ti 16GB(大显存支持COMSOL后处理中复杂三维模型的流畅旋转与切面显示) |
| 散热 | 240mm一体式水冷(长时间满载求解,避免CPU降频) |
方案二:专业仿真型
适合企业研发工程师处理中等规模(50万–200万自由度)的三维多物理场耦合模型,支持参数化扫描。
表格
| 组件 | 推荐配置 |
|---|---|
| CPU | Intel Core i9-14900K / AMD Ryzen 9 7950X(24核32线程 / 16核32线程,多核并行加速矩阵求解) |
| 内存 | 128GB DDR5-6000(四通道或双通道高容量,百万级自由度模型的刚需) |
| 存储 | 2TB NVMe SSD(PCIe 4.0)+ 4TB HDD(归档历史项目) |
| 显卡 | RTX 4070 Ti Super 16GB / RTX A4000 16GB(专业卡驱动更稳定,支持COMSOL的GPU加速后处理) |
| 散热 | 360mm一体式水冷或高端风冷(满载功耗250W+,温度控制是稳定求解的前提) |
| 显示器 | 双屏27英寸 2K/4K IPS(一屏建模,一屏监控求解器收敛曲线与后处理) |
方案三:企业级工作站
适合热设计团队、研究院所进行大规模(200万+自由度)复杂封装结构的全耦合瞬态分析、参数化优化与批量仿真。
表格
| 组件 | 推荐配置 |
|---|---|
| CPU | Intel Xeon W-3400系列(如W7-3465X,28核56线程,支持AVX-512,浮点性能强) / AMD Threadripper PRO 7000 WX系列(24核48线程起,超大内存通道带宽) |
| 内存 | 256GB–512GB ECC DDR5(ECC纠错保障长时间求解不崩溃,大容量支持超大规模矩阵驻留内存) |
| 存储 | 2TB NVMe SSD(系统+活跃项目)+ 8TB HDD(数据归档)+ 可选RAID阵列(项目备份) |
| 显卡 | RTX A5000 24GB / RTX 5000 Ada 32GB(大显存、专业驱动认证,支持复杂模型实时渲染与动画输出) |
| 网络 | 万兆网卡(团队共享仿真数据与许可证服务器) |
| 系统 | Windows 11 Pro for Workstations 或 Linux(CentOS/RHEL,根据COMSOL许可证与集群环境选择) |
六、写在最后:仿真不是"算命",而是"算准"
COMSOL多物理场耦合仿真,让工程师在虚拟空间中同时"看见"电流怎么走、热量怎么传、流体怎么流。它不是替代实验的"数字算命",而是缩短试错周期、降低研发成本的"精准导航"。
从结温估算到热沉优化,从电极布局到冷却策略,每一次耦合求解都在为产品的可靠性"买保险"。而一台算力充沛的图形工作站,则是让这份"保险"算得更快、更稳的底层基础设施。
毕竟,在芯片热到烫手的时代,算得快,就是竞争力。
UltraLAB图形工作站供货商:
西安坤隆计算机科技有限公司
国内知名高端定制图形工作站厂家
业务电话:400-705-6800
咨询微信号:100369800


