






一、仿真工程师的"最后一公里"困境
在工业厂房里,Fluent算出了管道内的湍流分布,Mechanical算出了弯头的应力集中,Abaqus验证了结构的疲劳寿命——仿真软件把"问题算清楚了",但项目汇报时,业主、运维人员和管理层看着一堆结果文件和孤立云图,仍然一脸茫然。
"算清楚"和"讲明白"之间,隔着一条名为"可视化"的鸿沟。 FEAView这类三维可视化组件,正是为跨越这条鸿沟而生。它不替代仿真软件,而是把CFD/FEA的结果"翻译"成所有人都能直观理解的三维场景语言。
但很多人忽略了一个关键问题:从仿真计算到三维可视化,背后是一条涉及四种完全不同计算特征的"技术流水线"。 给这条流水线配错硬件,轻则渲染卡顿、重则求解崩溃。本文将拆解每个环节的计算特点,并给出针对性的硬件配置方案。
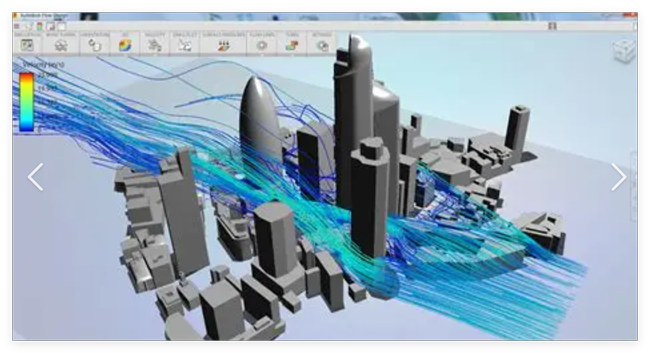
二、环节一:CFD计算——"流体怎么流"的算力黑洞
代表软件:Ansys Fluent、OpenFOAM、CFX、Star-CCM+
CFD(计算流体力学)求解的是Navier-Stokes方程组——一组描述质量、动量、能量守恒的非线性偏微分方程。以Fluent为例,一个典型的工业管道或叶片绕流仿真,计算流程如下:
-
网格划分:将连续空间离散为百万至数千万个网格单元(六面体、四面体、多面体);
-
方程离散:采用有限体积法(FVM)将PDEs转化为代数方程组;
-
迭代求解: SIMPLE/COUPLED算法反复迭代压力-速度场,直至残差收敛;
-
湍流建模:RANS(k-ε、k-ω)、LES或大涡模拟,引入额外输运方程。
计算特点:
-
内存带宽敏感:每个迭代步都需要全局扫描网格,内存带宽直接决定单步速度;
-
多核并行友好:压力修正方程和动量方程的求解可分解到多核/多节点,但强耦合部分存在通信瓶颈;
-
非线性与刚性:高雷诺数湍流、多相流、燃烧反应等场景收敛困难,可能需要数万次迭代;
-
数据输出庞大:瞬态结果、截面数据、流线数据,单个案例轻松输出数十GB。
硬件瓶颈:CPU核心数不足导致并行效率低;内存容量不够导致网格规模受限;SSD速度慢导致结果文件读写卡顿。
三、环节二:FEA计算——"结构怎么受力"的内存巨兽
代表软件:Ansys Mechanical、Abaqus、Nastran、COMSOL
FEA(有限元分析)求解的是结构力学控制方程(线弹性/弹塑性/大变形),核心流程是:
-
刚度矩阵组装:根据单元类型和材料属性,组装全局刚度矩阵 K ;
-
线性/非线性求解:Ku=F ,对于百万自由度以上的模型,采用稀疏矩阵直接求解器(MUMPS、PARDISO)或迭代求解器(PCG、AMG);
-
后处理计算:应力、应变、安全系数、接触状态的派生计算。
计算特点:
-
内存容量极度敏感:直接求解器的内存需求随自由度呈超线性增长(O(N1.5) 至O(N2) ),千万自由度模型需要上百GB内存;
-
双精度浮点刚需:刚度矩阵条件数大,单精度会导致数值不稳定甚至求解失败;
-
I/O密集:频繁读写矩阵因子、中间结果、重启动文件;
-
接触与非线性:大变形、摩擦接触、材料非线性会大幅增加迭代步数。
硬件瓶颈:内存不足时系统被迫使用虚拟内存,求解速度暴跌至原来的1/10;硬盘速度慢导致重启动和结果保存耗时过长。
四、环节三:数据转换与处理——从"仿真语言"到"可视化语言"
工具:Python脚本、ParaView、自研转换工具、FEAView数据预处理模块
仿真软件输出的原始数据(如Fluent的.cas/.dat、Abaqus的.odb、VTK格式)并不能直接被三维可视化引擎读取。必须经过一道"翻译"工序:
-
网格顶点关联:将仿真网格的单元数据插值到可视化所需的顶点或表面;
-
字段映射:把速度、压力、应力、温度等物理量按约定格式重组;
-
色表生成:将连续物理量映射为RGB色带(如蓝-绿-黄-红对应低温到高温);
-
文件格式转换:输出为JSON、FBX、glTF或引擎自定义格式。
计算特点:
-
CPU单核性能敏感:网格插值和字段映射多为串行算法,主频高则处理快;
-
内存随机访问密集:需要同时驻留原始网格、插值网格和属性数组;
-
SSD读写吞吐量:单个模型转换可能涉及数GB数据的读写,机械硬盘会成为明显瓶颈;
-
可批量化:多案例并行转换时,多核CPU可加速。
硬件瓶颈:机械硬盘导致转换耗时从分钟级变成小时级;内存不足导致无法一次性加载大模型进行全局插值。
五、环节四:三维可视化渲染——让数据"看得见"的图形挑战
代表工具:FEAView、CIMPro、Unity/Unreal数字孪生引擎、ParaView
这是仿真结果走向"业务端"的最后一站。三维可视化引擎需要实时渲染:
-
几何模型:厂房、设备、管线、阀门等CAD级高精度模型(可能包含数百万三角面);
-
仿真结果云图:将CFD/FEA的物理量以表面着色、体渲染、粒子流线的形式叠加到几何模型上;
-
交互操作:旋转、缩放、切面、时序播放、多物理量切换;
-
系统集成:嵌入CIMPro、三维工厂、数字孪生平台,支持多人协同和远程访问。
计算特点:
-
GPU显存决定模型上限:大场景+高分辨率云图纹理,显存不足会导致模型无法加载或贴图降级;
-
实时帧率要求:数字孪生场景要求30–60 FPS流畅交互,对GPU的光栅化性能和带宽要求高;
-
多屏/高分辨率输出:4K甚至8K大屏展示,像素填充率成倍增长;
-
CPU辅助计算:场景管理、LOD切换、数据流调度仍依赖CPU。
硬件瓶颈:游戏级显卡(如RTX 4060)在4K分辨率下渲染千万面级工厂场景会严重掉帧;显存不足导致无法同时加载流体场和结构场进行联合展示。
六、硬件配置推荐:为"仿真+可视化"全链路定制
基于上述四个环节的计算特征,以下推荐三类配置方案:
方案A:个人工程师全能型(相关机型 UltraLAB A330或AR350)
适合需要独立完成"仿真计算→数据转换→可视化展示"全流程的工程师。
表格
| 组件 | 推荐配置 | 选型逻辑 |
|---|---|---|
| CPU | Intel Core i7-14700K / AMD Ryzen 7 7700X | 8P+12E核,高主频加速数据转换,多核支持中等规模CFD/FEA |
| 内存 | 64GB DDR5-5600(双通道) | 满足200万自由度FEA或500万网格CFD的内存需求 |
| GPU | RTX 4070 Ti Super 16GB | 16GB显存可加载中等规模工厂场景+仿真云图,CUDA核心支持Fluent GPU求解 |
| 存储 | 2TB NVMe SSD(PCIe 4.0) | 快速读写仿真结果、转换中间文件、可视化工程包 |
| 显示器 | 27英寸 2K IPS | 分屏操作:左侧仿真软件,右侧可视化引擎 |
方案B:企业仿真计算型(相关机型 UltraLAB A330或AR330)
适合以CFD/FEA大规模求解为主、可视化展示为辅的研发团队。
表格
| 组件 | 推荐配置 | 选型逻辑 |
|---|---|---|
| CPU | Intel Core i9-14900K / AMD Ryzen 9 7950X(16核32线程) | 多核并行加速大规模稀疏矩阵求解与湍流迭代 |
| 内存 | 128GB DDR5-6000 | 支撑500万+自由度FEA或千万级网格CFD的直接求解 |
| GPU | RTX 4070 Ti Super 16GB / RTX A4000 16GB | 专业卡驱动更稳定,支持多屏输出与长时间渲染 |
| 存储 | 2TB NVMe SSD + 8TB HDD | SSD放活跃项目与系统,HDD归档历史仿真数据 |
| 散热 | 360mm一体式水冷 | 长时间CFD/FEA满载(CPU功耗250W+),温度稳定保障不降频 |
| 网络 | 万兆网卡 | 团队共享许可证服务器与仿真数据库 |
方案C:数字孪生/可视化展示型(相关机型 UltraLAB A330 或AR330)
适合以三维工厂、CIMPro、数字孪生平台部署为主,需要实时渲染大场景+多物理场联合展示的场景。
表格
| 组件 | 推荐配置 | 选型逻辑 |
|---|---|---|
| CPU | Intel Core i7-14700K / AMD Ryzen 7 7700X | 高主频保障场景管理与数据流调度,仿真计算由独立服务器承担 |
| 内存 | 64GB DDR5-5600 | 支撑大场景几何体与多帧仿真数据缓存 |
| GPU | RTX 5000 Ada 32GB / RTX A6000 48GB | 超大显存支持千万面级工厂模型+高分辨率云图纹理;专业驱动认证保障长时间稳定渲染 |
| 存储 | 2TB NVMe SSD | 快速加载大型可视化工程包(可能包含数十GB纹理与模型数据) |
| 显示器 | 双屏32英寸 4K IPS | 一屏主场景,一屏辅助面板/数据看板;或单屏超宽曲面屏 |
| 输出接口 | 多DP/HDMI输出 | 支持大屏、投影、多显示器拼接展示 |
方案D:企业级仿真+可视化工作站(预算 100,000–180,000元)
适合大型设计院、工程咨询公司,需要同时进行大规模求解和高端可视化。
表格
| 组件 | 推荐配置 | |
|---|---|---|
| CPU | Intel Xeon W-3400系列(如W7-3465X,28核56线程)或 AMD Threadripper PRO 7000 WX(24核48线程起) | |
| 内存 | 256GB–512GB ECC DDR5 | 支撑千万级自由度FEA/CFD;ECC纠错保障长时间计算不崩溃 |
| GPU | RTX 6000 Ada 48GB × 1~2 | 顶级显存与图形性能,支持最复杂数字孪生场景的实时渲染 |
| 存储 | 4TB NVMe SSD(PCIe 4.0×4)+ 16TB HDD(RAID 1) | 高吞吐读写+数据冗余 |
| 系统 | Windows 11 Pro for Workstations + 可选Linux双系统 | 兼容Fluent/Mechanical/Abaqus及可视化引擎 |
七、写在最后:算力是"翻译"的底气
仿真软件负责回答"物理上发生了什么",可视化工具负责回答"这意味着什么"。从CFD/FEA的数值求解,到数据转换的格式翻译,再到三维引擎的实时渲染,每个环节都在以不同的方式"压榨"硬件。
给仿真配一台好机器,是为了算得更快;给可视化配一块好显卡,是为了让结果被更多人看见。 当算力足够强大时,复杂的流场、应力场、温度场就不再是工程师的"专业黑话",而是所有人都能直观理解的"工程语言"。
在数字孪生和智能工厂的大趋势下,"算清楚"和"看明白"同样重要。而一台配置合理的工作站,就是连接这两个世界的桥梁。
UltraLAB图形工作站供货商:
西安坤隆计算机科技有限公司
国内知名高端定制图形工作站厂家
业务电话:400-705-6800
咨询微信号:100369800


