摘要:Fourier Neural Operator(FNO)把偏微分方程求解从“逐网格迭代”变成“一次前向推理”,是 AI for Science 方向最具代表性的神经算子之一。本文基于 FNO 原始论文与 NVIDIA Modulus 工程实现,拆解其谱卷积核心算法,分析训练与推理阶段的 GPU 显存、内存带宽瓶颈,并给出从入门到多卡训练的 UltraLAB 工作站分档配置与公开参考价。
关键词:FNO、傅里叶神经算子、AI for Science、神经算子、PDE求解、NVIDIA Modulus、科学机器学习、GPU工作站、UltraLAB工作站
- 一、摘要与适用读者
- 二、资料背景与核心观点
- 三、主要功能模块与核心算法
- 四、计算特点与性能瓶颈
- 五、典型应用场景
- 六、UltraLAB 硬件配置建议
- 七、软件清单
- 八、常见问题(FAQ)
- 九、可执行总结
一、摘要与适用读者
1.1 这篇资料解决了什么问题
传统数值方法求解偏微分方程(PDE)时,每换一次边界条件或物性参数就要重新离散、重新迭代,参数化研究和大规模优化设计的计算成本极高。FNO 论文提出直接在函数空间之间学习映射的“神经算子”:训练一次,即可对新的输入场在一次前向传播内给出解场预测,并且网络结构与网格分辨率解耦。
对工程团队的现实问题是:这类模型训练时吃 GPU 显存与算力,推理时几乎可以秒级出结果,工作站的配置重心应从“堆 CPU 核数”转向“GPU 显存容量 + 数据吞吐”。本文给出可落地的分档选型。
1.2 适用读者
- 从事计算流体力学、固体力学、电磁仿真,希望用 AI 代理模型(surrogate model)加速参数扫描与优化设计的科研与工程人员;
- 评估 NVIDIA Modulus、neuraloperator 等框架,准备搭建本地训练环境的实验室与高校团队;
- 需要向管理层解释“为什么 AI for Science 需要大显存 GPU 工作站而不是普通服务器”的技术负责人。
二、资料背景与核心观点
2.1 资料来源
| 资料 | 类型 | 机构/出处 | 链接 |
|---|---|---|---|
| Fourier Neural Operator for Parametric Partial Differential Equations | 论文(ICLR 2021) | Caltech 等,arXiv:2010.08895 | https://arxiv.org/abs/2010.08895 |
| NVIDIA Modulus(PyPI) | 厂商技术资料 | NVIDIA | https://pypi.org/project/nvidia-modulus/ |
| NeuralOperator 官方文档 | 开源项目文档 | neuraloperator 社区 | https://neuraloperator.github.io/ |
2.2 核心观点
- FNO 在傅里叶空间对积分核进行参数化:对输入做快速傅里叶变换(FFT),保留低频模态并乘以可学习的复数权重,再做逆变换,从而以近似线性复杂度逼近全局卷积算子;
- 网络学习的是“函数到函数”的映射而非固定网格上的回归,因此训练后可以在更细网格上直接推理(论文称为 zero-shot super-resolution);
- 论文在 Burgers 方程、Darcy 流与 Navier–Stokes 方程基准上验证了该方法,并报告推理相对传统求解器可达到数量级级别的加速;这类数字属于特定基准与实现条件下的结果,工程落地时应以自有算例实测为准;
- NVIDIA Modulus 将 FNO 等神经算子与物理约束损失(PINN 思路)整合进 PyTorch 工程框架,降低了在真实几何与边界条件下训练代理模型的门槛。
三、主要功能模块与核心算法
3.1 傅里叶层(Spectral Convolution)
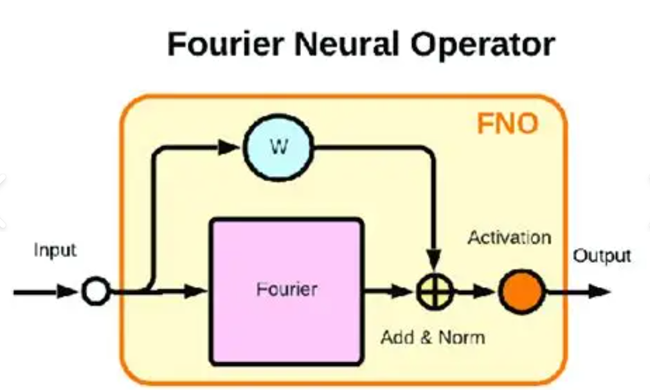
FNO 的基本单元是傅里叶层:对通道化的输入场执行 FFT,截断高频模态,仅对保留的低频模态施加复数权重矩阵,然后逆 FFT 回到物理空间,与逐点线性变换(1×1 卷积)相加后过激活函数。这个结构把全局感受野的积分算子压缩到谱空间的低秩更新,是“分辨率无关”的来源。
3.2 Lifting 与 Projection
输入的物理场(如初始涡量、材料参数)先经浅层网络升维到高维表示空间,堆叠若干傅里叶层后再投影回输出物理量。升维宽度与模态截断数是决定模型容量与显存占用的两个关键超参数。
3.3 训练目标与物理约束
纯数据驱动训练以观测解场的 L2 相对误差为损失;在 Modulus 等框架中,还可以把 PDE 残差、边界条件作为软约束加入损失,减少对标注数据的依赖。训练中每个样本是完整的场数据(二维或三维张量),批量加载对 I/O 与主机内存也有要求。
3.4 推理与下游耦合
训练完成的 FNO 可作为代理模型嵌入优化循环(形状优化、反问题、控制),一次前向即可给出一个候选设计的全场响应;此时瓶颈从“算力”转为“GPU 显存能否放下模型与批次场数据”。
四、计算特点与性能瓶颈
4.1 计算负载画像
FNO 训练属于典型的深度学习负载:FFT/IFFT、批量矩阵乘与卷积交替出现,GPU 利用率高;FFT 对显存带宽敏感,频域权重乘法对算力敏感。二维 FNO 模型规模通常在千万参数量级,单张 16GB 级显存即可开展;三维 FNO 或高模态数配置下,激活值与中间谱系数会迅速膨胀,24GB 以上显存才比较从容。数据集本身往往是以 TB 计的历史仿真结果,主机内存与 NVMe 吞吐决定数据加载是否拖后腿。
4.2 硬件瓶颈分析
| 环节 | 主要瓶颈 | 配置含义 |
|---|---|---|
| 模型训练(2D) | GPU 算力与 12–16GB 级显存 | 主流单卡即可,重点看 GPU 代际与显存余量 |
| 模型训练(3D/高模态) | 显存容量、显存带宽 | 24GB 以上显存起步;批量放不下时梯度累积会拉长训练时间 |
| 多模型/超参搜索 | GPU 数量与任务并发 | 多卡并行比单卡极限算力更重要 |
| 数据准备与加载 | 主机内存、NVMe 随机读 | 64GB 以上内存 + 大容量 NVMe 是稳妥基线 |
| 推理部署 | 显存容量与延迟 | 单卡即可,推理吞吐远超传统求解器 |
五、典型应用场景
- CFD 代理模型:翼型、叶栅、腔体流动的快速参数扫描,把单次评估从小时级压到秒级;
- 结构与材料:以材料参数场为输入预测应力/温度场,服务拓扑优化与反问题识别;
- 地球物理与气象:Darcy 流、浅水方程等时空演化问题的快速预报与集合生成;
- 教学科研:作为 AI for Science 入门算例,与 PINN、DeepONet 做方法对比。
六、UltraLAB 硬件配置建议
6.1 分档配置与公开参考价
以下配置与价格依据《UltraLAB图形工作站基准配置表2026v3》(2026年9月),为公开基准报价,实际以厂商确认为准。
| 档位 | 机型 | CPU / 内存 | GPU | 存储 | 公开参考价 | 适配场景 |
|---|---|---|---|---|---|---|
| 入门研究型 | A350 15064-MBX | Intel Ultra5 265K 20核 / 64GB DDR5 | RTX 5060Ti 16GB | 4TB NVMe + 8TB SATA | ¥36,000 | 二维 FNO 教学与中小规模训练、推理验证 |
| 主流训练型 | A350 15396-MCT | Intel Ultra-270Kplus 24核 / 96GB DDR5 | RTX 5090D 32GB(水冷) | 4TB NVMe + 8TB SATA | ¥89,990 | 三维 FNO、较高模态数单卡训练,兼顾仿真前处理 |
| 多卡训练型 | GE430M 135384-MC4T | AMD 霄龙 7763 64核 / 384GB DDR4 | 4×RTX 4090 48GB(水冷) | 4TB NVMe + 20TB SATA | ¥269,000 | 多卡并行训练、超参搜索、多任务并发与团队共享 |
6.2 选型说明与边界
- FNO 官方论文未给出强制硬件清单;上表按 PyTorch 深度学习的一般显存规律条件化给出:二维问题 16GB 显存通常够用,三维或高分辨率训练建议 32GB 起步,多卡配置用于并发而非必然加速单任务;
- 若训练数据由本机 CFD/FEA 软件生成,CPU 核数与内存通道数会影响前处理吞吐,主流档的 24 核高主频配置兼顾了“仿真 + 训练”混合负载;
- RTX 4090/5090D 属消费级 GPU,双精度算力与 ECC 支持有限;若代理模型训练需要 FP64 或长时无人值守训练,应在下单前与厂商确认是否更换专业卡。
七、软件清单
| 软件 | 角色 | 许可 | 获取方式 |
|---|---|---|---|
| PyTorch(CUDA 版) | 深度学习框架 | 开源(BSD) | https://pytorch.org |
| neuraloperator | FNO 参考实现 | 开源(MIT) | https://github.com/neuraloperator/neuraloperator |
| NVIDIA Modulus | 物理机器学习框架(含 FNO/PINN) | 开源(Apache-2.0) | https://pypi.org/project/nvidia-modulus/ |
| NumPy / SciPy / HDF5 | 数据处理与场数据存储 | 开源 | https://numpy.org |
| ParaView | 场数据可视化 | 开源(BSD) | https://www.paraview.org |
| OpenFOAM / SU2(可选) | 生成训练数据的求解器 | 开源(GPL) | https://www.openfoam.com |
八、常见问题(FAQ)
8.1 FNO 训练一定要用专业计算卡吗?
不一定。FNO 训练以 FP32/混合精度为主,消费级 RTX 显卡即可胜任多数研究场景;专业卡的价值在于 ECC 显存、长时稳定性与厂商支持。若训练任务连续运行数周且对结果可靠性敏感,再考虑 RTX Pro 或数据中心级 GPU。
8.2 16GB 显存能训三维 FNO 吗?
取决于分辨率、模态数与 batch size。小规模三维算例(如 64³ 网格、低模态数)在 16GB 上通常可以跑通,但需要小批量与梯度累积;64³ 以上或模态数较大时建议 24–32GB 显存,避免频繁溢出重试。
8.3 FNO 能完全替代传统求解器吗?
不能。FNO 是用历史数据学习特定方程族的解算子,精度受训练分布限制,外推场景需要谨慎验证;合理定位是“在训练分布内做快速代理与初值猜测”,关键结果仍应由高保真求解器复核。
8.4 CPU 在 FNO 工作流中重要吗?
训练阶段 GPU 是绝对主力,CPU 主要负责数据加载与预处理;但如果训练数据靠本机 CFD 仿真现算,CPU 核数与主频会直接决定数据产出速度,这也是推荐高主频多核配置的原因。
九、可执行总结
- 先用 neuraloperator 官方示例在小算例上复现 FNO,确认工作流,再规划数据生成规模;
- 二维研究选 16GB 显存的 A350 15064-MBX 即可起步,三维训练直接上 32GB 显存的 A350 15396-MCT;
- 需要多模型并发或团队共享时,选择 4×RTX 4090 48GB 的 GE430M 135384-MC4T,并配足 NVMe 数据盘;
- 上线前用自有算例对比 FNO 代理与传统求解器的精度与耗时,形成内部基准,再决定替代比例。
附:AI for Science 选型注意事项
- 神经算子的“加速比”高度依赖基准设置,宣传数字不等于你的算例收益;
- 训练数据生成往往比训练本身更耗时,仿真与训练最好在同一台机器或同一存储上完成;
- CUDA 版本、PyTorch 版本与 GPU 架构需匹配,新机到手先跑通官方 Docker 或 conda 环境再迁移代码。
参考资料
- Fourier Neural Operator for Parametric Partial Differential Equations(arXiv:2010.08895):https://arxiv.org/abs/2010.08895
- NVIDIA Modulus(PyPI 项目页):https://pypi.org/project/nvidia-modulus/
- NeuralOperator 官方文档:https://neuraloperator.github.io/
- UltraLAB图形工作站基准配置表2026v3(用户提供):#
免责声明:本文所引用的论文、文档与厂商资料均来自公开渠道,链接以撰稿时可访问的版本为准;文中 UltraLAB 机型配置与价格依据《UltraLAB图形工作站基准配置表2026v3》(2026年9月),为公开基准报价,实际成交配置、价格、库存与交货周期请以厂商最新确认为准。软件版本、GPU 加速支持范围与许可证条款可能随版本更新发生变化,部署前请核对官方最新文档。