






32–128 核超算平台 + AI 大模型推理能力全解析
当科学计算遇上 AI 大模型,CPU 超多核 + 超大内存 的平台展现出独特价值。本文深度解析 UltraLAB AE430/AX450/AE450 高频图形工作站 7 款配置——从 32 核霄龙到 128 核至尊 Xeon,覆盖科学计算、电磁仿真、CAE、EDA、8K 影视到 7B–70B 大模型本地部署,为你呈现一份完整的应用场景与 AI 推理能力指南。
目录
一、系列概览:水冷高性能图形工作站的独特定位
UltraLAB AE430/AX450/AE450 系列与 A350/GR450P 系列形成鲜明互补:
| 对比维度 | A350/GR450P 系列 | AE430/AX450/AE450 系列 |
|---|---|---|
| CPU 路线 | Intel 桌面旗舰 / AMD 线程撕裂者 | AMD 霄龙 EPYC / Intel Xeon 服务器级 |
| 核心数 | 14–96 核 | 32–128 核 |
| 内存 | 32–384GB DDR5 | 128–384GB DDR4/DDR5 |
| 缓存 | 标准 | 超大 L3 缓存(480–768MB) |
| 显卡 | RTX 4090/5090/A100 旗舰 | RTX 5060Ti/5080/Pro 5000 中高档 |
| 核心优势 | 单核高频 + 大显存 GPU | 超多核并行 + 超大内存 + 大缓存 |
| 最佳场景 | AI 推理、影视后期、设计 | 科学计算、电磁仿真、CAE、CPU 密集型任务 |
关键认知:AE430/AX450/AE450 系列并非以 GPU AI 推理为主打,而是凭借 32–128 核 + 128–384GB 内存 + 超大 L3 缓存,在 CPU 密集型科学计算领域建立壁垒。同时,超大内存使其具备 CPU 内存推理大模型 的独特能力——虽然速度不及 GPU,但可加载远超显存容量的模型。
二、七款配置详解与应用场景 { #section-configs}
2.1 方案一:AE430 131128-MBX | 高频计算工作站
¥59,990 | AMD 霄龙 7573X (32核 3.1GHz, 768MB L3) + 128GB DDR4 + RTX 5060Ti 16GB + 水冷
核心定位
入门级超多核科学计算平台——以 32 核霄龙 + 768MB 超大 L3 缓存 + 128GB 内存,打通"科学计算 + 轻量 AI"双赛道。
详细应用场景
| 场景 | 具体工作负载 | 能力说明 |
|---|---|---|
| 科学计算与数值模拟 | MATLAB 大规模矩阵运算、Python NumPy/SciPy 科学计算、蒙特卡洛仿真、优化算法 | 32 核 + 768MB L3 缓存加速大规模并行数值计算 |
| 设计与仿真 | ANSYS 结构静力分析、Fluent 中等规模 CFD、COMSOL 多物理场耦合 | 128GB 内存支撑百万级网格节点的有限元求解 |
| EDA 芯片设计后仿验证 | Vivado 千万门级 FPGA 后仿、Cadence 数字仿真波形分析 | 超大 L3 缓存加速仿真数据缓存命中 |
| CT 重建 | 医学 CT 图像重建(FDK 算法)、工业 CT 三维可视化 | 32 核并行加速反投影运算 |
| 油藏模拟 | Eclipse/Petrel 中等规模油藏数值模拟 | 128GB 内存加载百万网格节点油藏模型 |
| AI 辅助计算 | 本地部署 14B 量化模型辅助参数优化、脚本生成 | RTX 5060Ti 16GB 可流畅运行 14B Q4 模型 |
AI 大模型推理能力
| 推理方式 | 支持模型 | 速度/说明 |
|---|---|---|
| GPU 推理 | 14B Q4 (流畅)、7B Q8 (流畅) | ~20–35 token/s |
| CPU 内存推理 | 32B Q4 (128GB 内存刚好够)、14B Q8 | ~2–5 token/s(32 核并行) |
典型用户画像
- 高校计算物理/计算化学课题组
- 中小型油藏模拟研究团队
- 医疗器械公司 CT 算法工程师
- 独立科学计算开发者
2.2 方案二:AE430 130192-MBX | 电磁仿真全能高频工作站
¥79,990 | AMD 霄龙 9375F (64核 3.0GHz, 768MB L3) + 192GB DDR4 + RTX 5070Ti 16GB + 水冷
核心定位
电磁仿真与芯片设计的 64 核高频平台——768MB L3 缓存 + 192GB 内存,专为频域电磁仿真和大型结构分析优化。
详细应用场景
| 场景 | 具体工作负载 | 能力说明 |
|---|---|---|
| 电磁仿真计算(频域) | ANSYS HFSS 天线设计、SIwave 信号完整性、ADS 微波电路仿真 | 64 核 + 768MB L3 加速频域有限元/矩量法矩阵求解 |
| 芯片设计与仿真 | Cadence Virtuoso 模拟电路仿真、Synopsys 数字后端验证 | 192GB 内存加载千万门级电路网表与仿真数据 |
| 结构静力仿真 | ABAQUS 大型装配体强度分析、Nastran 模态分析 | 64 核并行加速大型刚度矩阵求解 |
| AI 辅助电磁设计 | 14B 模型辅助天线参数优化、PCB 布局建议 | RTX 5070Ti 16GB 运行 14B Q4 模型 |
AI 大模型推理能力
| 推理方式 | 支持模型 | 速度/说明 |
|---|---|---|
| GPU 推理 | 14B Q4 (流畅)、7B Q8 (流畅) | ~25–40 token/s |
| CPU 内存推理 | 70B Q4 (192GB 内存可加载)、32B Q8 | ~3–6 token/s(64 核并行) |
亮点:192GB 内存使其成为全系首款可 CPU 推理 70B 模型 的配置,适合需要大模型辅助但预算有限的科研团队。
典型用户画像
- 通信设备公司天线工程师
- 芯片设计公司电磁兼容工程师
- 航空航天结构强度分析师
2.3 方案三:AE450 135256-MCX | GPU 计算高频工作站
¥99,000 | AMD 霄龙 9654 (96核 3.55GHz) + 256GB DDR5 + RTX 5060Ti 16GB + 水冷
核心定位
AI 训练与科学计算的 96 核均衡平台——96 核超高并行 + 256GB DDR5 + 16GB 显存,覆盖从蛋白质折叠到 8K 视频调色的全场景。
详细应用场景
| 场景 | 具体工作负载 | 能力说明 |
|---|---|---|
| AI 训练与推理 | PyTorch 中小型模型训练(ResNet/ViT)、LLM 微调(LoRA 7B–14B)、推理服务部署 | 96 核 + 256GB 内存支撑数据并行训练,16GB 显存适合 LoRA 微调 |
| 蛋白质折叠 | AlphaFold2 结构预测、Rosetta 蛋白质设计 | 96 核并行加速 MSA 搜索与结构优化 |
| 冷冻电镜图像建模 | RELION/cryoSPARC 颗粒挑选、三维重构、分辨率评估 | 256GB 内存加载数万张电镜图像数据集 |
| 分子动力模拟 | GROMACS/NAMD 百万原子体系模拟 | 96 核 + DDR5 高带宽加速并行分子动力学 |
| 8K 视频调色/渲染 | DaVinci Resolve 8K 调色、Blender Cycles 渲染 | RTX 5060Ti 16GB 支撑 8K 代理文件实时预览 |
AI 大模型推理能力
| 推理方式 | 支持模型 | 速度/说明 |
|---|---|---|
| GPU 推理 | 14B Q4 (流畅)、7B Q8 (流畅) | ~20–35 token/s |
| CPU 内存推理 | 70B Q4 (256GB 内存充裕)、70B Q8 (接近上限) | ~4–8 token/s(96 核并行) |
亮点:256GB DDR5 内存使其可 CPU 推理 70B Q4 甚至 70B Q8,是预算 ¥10 万以内唯一能尝试 70B 全精度量化的配置。
典型用户画像
- 生物信息学/结构生物学实验室
- AI 初创公司训练工程师
- 冷冻电镜平台技术员
2.4 方案四:AX450 135128-MCX | 至尊 CAE 仿真超算工作站
¥116,000 | Xeon 6952P (96核 3.5GHz, 480MB L3) + 128GB DDR5 + RTX 5060Ti 16GB + 水冷
核心定位
CAE 仿真的 96 核 Xeon 旗舰——Intel 至强平台 + 480MB L3 缓存,在电磁仿真时域/频域和芯片设计验证领域提供极致算力。
详细应用场景
| 场景 | 具体工作负载 | 能力说明 |
|---|---|---|
| 仿真计算(电磁时域/频域) | CST Studio Suite 时域电磁仿真、ANSYS HFSS 频域求解、FEKO 矩量法 | 96 核 Xeon + 480MB L3 加速大型稀疏矩阵迭代求解 |
| 双虚拟机加速计算 | 同时运行 Windows(CAD)+ Linux(CAE)双系统,各分配 48 核 | 96 核物理核心支撑双虚拟机并行,互不干扰 |
| 芯片设计/后仿 | Synopsys VCS 大规模回归验证、Cadence Xcelium 仿真 | 128GB 内存加载大型测试平台与波形数据库 |
AI 大模型推理能力
| 推理方式 | 支持模型 | 速度/说明 |
|---|---|---|
| GPU 推理 | 14B Q4 (流畅)、7B Q8 (流畅) | ~20–35 token/s |
| CPU 内存推理 | 32B Q4 (128GB 内存刚好够)、14B Q8 | ~4–7 token/s(96 核并行) |
注意:128GB 内存限制了 CPU 推理上限,无法加载 70B 模型。如需大模型辅助,建议搭配云端 API 或升级内存。
典型用户画像
- 汽车主机厂电磁兼容实验室
- 芯片设计公司验证团队
- 国防科研院所 CAE 工程师
2.5 方案五:AE450 141256-MCX | 8K 后期处理超级工作站
¥165,000 | AMD 霄龙 9575 (128核 3.2GHz) + 256GB DDR5 + RTX 5080 16GB + 水冷
核心定位
8K 影视工业与科学可视化的 128 核超级工作站——128 核 + 256GB 内存 + RTX 5080,重新定义"8K 实时剪辑 + 科学动画渲染"的同步工作流。
详细应用场景
| 场景 | 具体工作负载 | 能力说明 |
|---|---|---|
| 8K 视频剪辑 | DaVinci Resolve 8K 多机位时间线、RED RAW 8K 实时回放 | RTX 5080 16GB 加速 8K 代理文件解码与调色节点 |
| 特效合成 | Nuke 8K 合成、Houdini 大规模粒子特效预览 | 128 核加速特效解算与渲染农场任务预处理 |
| 动画渲染 | Blender Cycles/Maya Arnold 动画序列渲染 | 128 核 CPU 渲染作为 GPU 渲染的有力补充 |
| 调色 | Baselight/SpeedGrade 8K HDR 调色、ACES 色彩管理 | RTX 5080 支撑 10bit 4:4:4 色彩空间实时预览 |
| 科学可视化 | ParaView 十亿网格体数据可视化、VTK 医学图像三维重建 | 256GB 内存加载超大规模科学数据集 |
AI 大模型推理能力
| 推理方式 | 支持模型 | 速度/说明 |
|---|---|---|
| GPU 推理 | 14B Q4 (流畅)、7B Q8 (流畅) | ~30–45 token/s (RTX 5080) |
| CPU 内存推理 | 70B Q4 (256GB 内存充裕)、32B Q8 | ~5–10 token/s(128 核并行) |
亮点:128 核 CPU 推理 70B 模型可达 5–10 token/s,虽不及 GPU,但已足够支撑后台知识库查询与批量文档处理。
典型用户画像
- 影视后期公司技术总监
- 科学可视化团队(气象/海洋/天文)
- 纪录片制作公司 DIT 工程师
2.6 方案六:AX450 132256-MCX | 高性能仿真计算工作站
¥192,000 | Xeon 6980P (128核 3.2GHz, 503MB L3) + 256GB DDR5 + RTX 5080 16GB + 水冷
核心定位
共享图形服务器与频域极致计算平台——128 核 Xeon + 503MB L3 + 256GB 内存,支持虚拟双机加速与多用户并发。
详细应用场景
| 场景 | 具体工作负载 | 能力说明 |
|---|---|---|
| 共享图形服务器 | 3–5 人远程桌面同时运行 SolidWorks/CATIA/ANSYS | 128 核 + 256GB 内存通过虚拟化分配资源 |
| 频域极致计算 | ANSYS HFSS 超大规模天线阵列、CST 频域求解器 | 503MB L3 缓存减少矩阵求解的内存访问延迟 |
| EDA 设计与后仿 | 亿门级芯片后端验证、物理验证(DRC/LVS) | 128 核并行跑回归测试,缩短验证周期 |
| 工业 CT 重建 | 大型工件 CT 扫描数据三维重建、缺陷检测 | 256GB 内存加载高分辨率 CT 体数据 |
AI 大模型推理能力
| 推理方式 | 支持模型 | 速度/说明 |
|---|---|---|
| GPU 推理 | 14B Q4 (流畅)、7B Q8 (流畅) | ~30–45 token/s |
| CPU 内存推理 | 70B Q4 (256GB 内存充裕)、32B Q8 | ~5–10 token/s(128 核并行) |
| 多用户共享推理 | 5 用户各跑 7B Q4(CPU 内存) | 各用户 ~3–5 token/s |
亮点:作为共享服务器时,可在后台部署 70B Q4 大模型服务,为团队提供统一的知识库查询与代码辅助。
典型用户画像
- 大型设计院仿真中心管理员
- 芯片设计公司 IT 架构师
- 工业检测公司 CTO
2.7 方案七:AE450 141384-MDD | 异构高性能计算平台
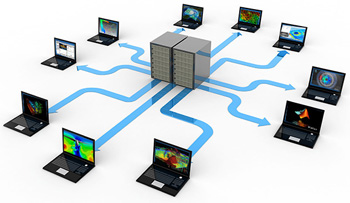
¥275,000 | AMD 霄龙 9755 (128核 4.1GHz, 512MB L3) + 384GB DDR5 + RTX Pro 5000 48GB + Quadro T400 + 水冷
核心定位
全能异构计算中心——128 核 4.1GHz 超高频霄龙 + 384GB 内存 + RTX Pro 5000 48GB 专业计算卡,单台即可替代小型服务器集群。
详细应用场景
| 场景 | 具体工作负载 | 能力说明 |
|---|---|---|
| 共享/虚拟图形服务器 | 5–8 人远程桌面同时运行 CAD/CAE/AI 推理 | 384GB 内存支撑多用户会话隔离与大型模型驻留 |
| 设计与仿真全能 | SolidWorks/CATIA 大型装配体 + ANSYS Fluent 千万网格 CFD + MATLAB 并行计算 | 128 核 + 384GB 内存同时驾驭设计与仿真 |
| 科学计算 | VASP 第一性原理大体系计算、Quantum ESPRESSO 声子谱计算 | 4.1GHz 高频 + 512MB L3 加速平面波基组迭代 |
| 人工智能训练 | LLaMA-3 70B LoRA 微调、Stable Diffusion XL 模型训练、多模态大模型预训练 | RTX Pro 5000 48GB 显存可加载 70B 模型进行 LoRA 微调 |
AI 大模型推理能力
| 推理方式 | 支持模型 | 速度/说明 |
|---|---|---|
| GPU 推理 | 70B Q4 (48GB 显存刚好够)、32B Q8 (流畅)、双开 32B+14B | ~10–20 token/s (RTX Pro 5000) |
| CPU 内存推理 | 70B Q8 (384GB 内存充裕)、70B Q4 (有余量) | ~6–12 token/s(128 核 4.1GHz) |
| 多用户共享推理 | 8 用户各跑 14B Q4(GPU/CPU 混合) | 各用户独立会话 |
核心亮点:
- RTX Pro 5000 48GB 是全系唯一可 GPU 推理 70B Q4 的配置
- 384GB 内存 可 CPU 推理 70B Q8 甚至尝试 70B FP16(需内存优化)
- 128 核 4.1GHz 是全系最高 CPU 频率,CPU 推理速度媲美入门级 GPU
典型用户画像
- 科研院所高性能计算中心主任
- AI 大模型创业公司 CTO
- 大型制造企业数字化部门负责人
- 国家级实验室技术主管
三、AI 大模型推理能力对照表 { #section-ai-deployment}
3.1 全系 7 款配置大模型推理能力总表
| 方案 | 型号 | 价格 | CPU | 显卡/显存 | 内存 | GPU 推理上限 | CPU 内存推理上限 | 核心用途 |
|---|---|---|---|---|---|---|---|---|
| 1 | AE430 131128-MBX | ¥59,990 | 霄龙 7573X 32核 3.1GHz | RTX 5060Ti / 16GB | 128GB DDR4 | 14B Q4 | 32B Q4 | 科学计算/EDA/油藏模拟 |
| 2 | AE430 130192-MBX | ¥79,990 | 霄龙 9375F 64核 3.0GHz | RTX 5070Ti / 16GB | 192GB DDR4 | 14B Q4 | 70B Q4 | 电磁仿真/芯片设计/结构仿真 |
| 3 | AE450 135256-MCX | ¥99,000 | 霄龙 9654 96核 3.55GHz | RTX 5060Ti / 16GB | 256GB DDR5 | 14B Q4 | 70B Q4/Q8 | AI 训练/蛋白质折叠/分子动力学 |
| 4 | AX450 135128-MCX | ¥116,000 | Xeon 6952P 96核 3.5GHz | RTX 5060Ti / 16GB | 128GB DDR5 | 14B Q4 | 32B Q4 | CAE 仿真/双虚拟机/芯片验证 |
| 5 | AE450 141256-MCX | ¥165,000 | 霄龙 9575 128核 3.2GHz | RTX 5080 / 16GB | 256GB DDR5 | 14B Q4 | 70B Q4 | 8K 影视/科学可视化/动画渲染 |
| 6 | AX450 132256-MCX | ¥192,000 | Xeon 6980P 128核 3.2GHz | RTX 5080 / 16GB | 256GB DDR5 | 14B Q4 | 70B Q4 | 共享服务器/频域计算/EDA |
| 7 | AE450 141384-MDD | ¥275,000 | 霄龙 9755 128核 4.1GHz | RTX Pro 5000 / 48GB | 384GB DDR5 | 70B Q4 | 70B Q8 | 全能异构计算/AI 训练/团队共享 |
3.2 推理速度参考
| 模型 | 推理方式 | 配置 | 速度 (token/s) | 说明 |
|---|---|---|---|---|
| 7B Q4 | GPU | RTX 5060Ti/5080 | 25–45 | 流畅对话 |
| 14B Q4 | GPU | RTX 5060Ti/5070Ti/5080 | 20–40 | 高质量代码/文档 |
| 32B Q4 | CPU 内存 | 64–128 核 + 192–256GB | 3–10 | 可接受的后台查询 |
| 70B Q4 | GPU | RTX Pro 5000 48GB | 10–20 | 企业级知识库 |
| 70B Q4 | CPU 内存 | 128 核 + 256–384GB | 5–12 | 无 GPU 时的备用方案 |
| 70B Q8 | CPU 内存 | 128 核 + 384GB | 4–8 | 高质量长文档分析 |
3.3 多 Agent 部署建议
| 配置 | 部署策略 | 适用场景 |
|---|---|---|
| 方案 1–6 | 单模型服务 | 个人/小团队使用,14B GPU 推理为主,70B CPU 推理为后台批处理 |
| 方案 7 | 多模型并发 | 团队共享:70B GPU 推理(核心 Agent)+ 32B CPU 推理(辅助 Agent)+ 14B GPU 推理(轻量任务) |
四、CPU 推理 vs GPU 推理:超多核平台的优势 { #section-cpu-vs-gpu}
4.1 为什么超多核工作站适合 CPU 推理?
传统认知中,大模型推理必须依赖 GPU。但 AE430/AX450/AE450 系列凭借以下特点,使 CPU 内存推理 成为可行方案:
| 优势 | 说明 | 影响 |
|---|---|---|
| 超多核 | 32–128 核物理核心,可并行处理多个注意力头 | 推理速度从 "不可用" 提升至 "可接受" |
| 超大内存 | 128–384GB,远超消费级 GPU 的 8–48GB 显存 | 可加载 70B 甚至更大模型 |
| 超大 L3 缓存 | 480–768MB,减少内存访问延迟 | 矩阵运算缓存命中率高,弥补内存带宽不足 |
| DDR5 高带宽 | 双通道/四通道 DDR5 提供 100–200GB/s 带宽 | 虽不及 GPU HBM,但足以支撑推理 |
| 无需显存限制 | 模型直接加载到内存,不受 48GB 显存天花板限制 | 可尝试 70B Q8、甚至 FP16 |
4.2 适用场景对比
| 场景 | GPU 推理 | CPU 内存推理 |
|---|---|---|
| 实时对话 | ✅ 首选,20–40 token/s | ❌ 太慢,3–10 token/s |
| 后台批处理 | ✅ 高效 | ✅ 可接受,夜间跑任务 |
| 超长上下文 | ⚠️ 受显存限制 | ✅ 内存充裕,128K+ 无压力 |
| 超大模型(70B+) | ⚠️ 需 A100/H100 | ✅ 384GB 内存可加载 70B Q8 |
| 多用户并发 | ⚠️ 显存碎片化 | ✅ 内存大,隔离容易 |
| 成本敏感 | ❌ GPU 贵 | ✅ 利用现有 CPU 资源 |
4.3 推荐组合策略
黄金法则:GPU 跑 14B 实时交互,CPU 跑 70B 后台批处理。
┌─────────────────────────────────────────┐
│  实时交互层(GPU 推理)                    │
│  • 14B Q4 模型:代码补全、即时问答        │
│  • 速度:25–45 token/s                   │
│  • 显存占用:~9GB(RTX 5060Ti/5080)     │
├─────────────────────────────────────────┤
│  后台批处理层(CPU 内存推理)              │
│  • 70B Q4 模型:长文档分析、知识库查询    │
│  • 速度:5–12 token/s(128 核)          │
│  • 内存占用:~43GB(256–384GB 平台)     │
└─────────────────────────────────────────┘
五、常见问题与硬件配置分析 { #section-faq}
5.1 为什么这些配置显卡只有 16GB?够用吗?
Q:¥10 万+的工作站,显卡才 16GB,是不是太弱了?
A:这些配置的设计哲学是 "CPU 为主、GPU 为辅"。16GB 显存足以支撑:
- 专业软件的 3D 视图渲染(CAD/CAE 后处理)
- 14B Q4 大模型的 GPU 推理(代码补全、设计辅助)
- 8K 视频代理文件解码
真正的算力来自 32–128 核 CPU + 128–384GB 内存,用于科学计算、仿真求解和 CPU 内存推理。如需更强 GPU,可考虑 GR450P 系列(RTX 5090D 32GB / A100 80GB)。
5.2 128GB 内存和 256GB 内存怎么选?
Q:AE430 131128-MBX(128GB)和 AE450 135256-MCX(256GB)差 ¥4 万,怎么选?
A:关键看是否需要 CPU 推理 70B 模型:
| 内存 | 可加载最大模型 (CPU) | 适用场景 |
|---|---|---|
| 128GB | 32B Q4 / 14B Q8 | 中等规模仿真、轻量 AI 辅助 |
| 192GB | 70B Q4 | 电磁仿真 + 大模型知识库 |
| 256GB | 70B Q4/Q8 | 蛋白质折叠、8K 影视、科学可视化 |
| 384GB | 70B Q8 / 尝试 FP16 | 团队共享、AI 训练、全能计算 |
5.3 AMD 霄龙 vs Intel Xeon 怎么选?
Q:同样是 96 核,选霄龙 9654 还是 Xeon 6952P?
| 维度 | AMD 霄龙 9654 | Intel Xeon 6952P |
|---|---|---|
| 频率 | 3.55GHz | 3.5GHz |
| L3 缓存 | 更大 | 480MB |
| 内存 | DDR5,带宽更高 | DDR5,延迟更低 |
| 软件生态 | 科学计算/仿真优化好 | EDA/CAE 部分软件优化更好 |
| 价格 | ¥99,000 | ¥116,000 |
| 推荐 | 通用科学计算、AI 训练 | 特定 EDA 工具(如 Synopsys) |
5.4 RTX Pro 5000 48GB 是什么卡?
Q:方案 7 的 RTX Pro 5000 48GB 和 RTX 4090 48GB 有什么区别?
A:RTX Pro 5000 是 NVIDIA 专业级工作站显卡(Ada 架构),相比消费级 RTX 4090:
- ✅ ECC 显存纠错:科学计算更可靠
- ✅ ISV 认证:SolidWorks/CATIA/ANSYS 官方认证
- ✅ 双精度浮点:FP64 性能是 RTX 4090 的 2–4 倍
- ✅ 驱动稳定性:专为 24×7 工作站环境优化
- ❌ 游戏性能:略低于 RTX 4090
- ❌ 价格:远高于 RTX 4090
对于 ¥27.5 万的全能计算平台,RTX Pro 5000 48GB 是 专业可靠性与大显存 的最佳平衡。
5.5 这些配置适合做 AI 训练吗?
Q:能用来训练大模型吗?
A:适合 LoRA 微调和小规模全参数训练,不适合大规模预训练。
| 训练任务 | 可行性 | 说明 |
|---|---|---|
| 7B 全参数微调 | ✅ 可行 | 16GB 显存刚好够,配合 256GB 内存 offloading |
| 14B LoRA 微调 | ✅ 推荐 | RTX 5060Ti/5080 16GB 是 LoRA 甜点配置 |
| 70B LoRA 微调 | ✅ 仅方案 7 | RTX Pro 5000 48GB 可加载 70B 模型 + LoRA |
| 70B 全参数训练 | ❌ 不可行 | 需要多卡 A100/H100 + NVLink |
| Stable Diffusion 训练 | ✅ 可行 | 16GB 显存可训练 SD 1.5/SDXL LoRA |
5.6 水冷散热对超多核 CPU 的重要性
Q:96–128 核 CPU 发热量大吗?必须水冷吗?
A:必须水冷。霄龙 9654(96 核)TDP 达 360W,Xeon 6980P(128 核)TDP 达 500W,风冷完全无法压制。水冷不仅保障频率,更保障 24×7 长时间运行的稳定性——对于油藏模拟、分子动力学等动辄数天的计算任务,稳定性比峰值性能更重要。
免责声明:本文基于 UltraLAB 图形工作站基准配置表 2026v1 整理撰写。硬件配置与价格以厂商最新报价为准。CPU 内存推理速度受模型版本、量化方案、内存带宽、CPU 核心数等多因素影响,实际表现可能存在差异。大模型推理建议优先使用 GPU,CPU 推理仅作为显存不足时的备用方案。


