






定位:Pmax 系列为双路 AMD EPYC + 双 GPU 架构便携异构计算平台,单台最高 256 核,双 GPU 合计最高 192GB 显存,支持模型并行、数据并行、GPU 虚拟化,面向石油勘探、核物理仿真、基因测序、国家级密码破译、亿级参数大模型离线训练推理场景,整机加固便携,野外 / 涉密隔离环境可独立运行,数据完全本地闭环。
核心选型逻辑:双路 CPU 多核多线程能力是海量数据预处理、多源并行仿真的核心;双 GPU 显存总和决定大模型训练与推理规模;超大容量 ECC 内存支撑超长上下文、大规模数据集、分子动力学模拟等高内存负载。
5.1 Pmax650GD 238512-MCC|¥183,000
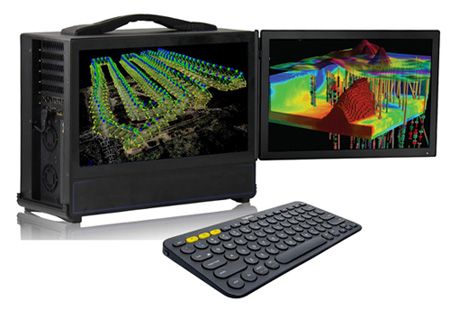
硬件配置:2×AMD 霄龙 75F3(合计 64 核,3.8~4.0GHz)|2×RTX PRO 4500 32GB(合计 64GB 显存)|512GB DDR4 ECC|4TB NVMe|双屏 17" 4K 便携一体(2000W)
核心定位:双 EPYC 64 核全能渲染工作站,面向大型三维场景实时渲染、医学影像 AI 训练、地质勘探数据反演、高端 BIM 模型审查场景。
表格
| 业务负载 | 场景说明 |
|---|---|
| 大型三维场景实时渲染、高端 BIM 模型审查 | 双路 64 核并行加载超大体量 BIM 模型,双 RTX PRO4500 专业卡 ISV 认证,双屏分屏显示模型与审查报告,无卡顿实时漫游 |
| 医学影像 AI 训练、地质勘探数据反演 | 512GB 大内存承载海量 CT 影像、地质勘探数据集,双 GPU 并行做轻量化模型微调,现场离线完成 AI 训练与推理 |
本地大模型推理能力 GPU 流畅:32B Q8_0 高质量流畅,70B Q4_K_M 双卡张量并行流畅;CPU 内存可卸载运行 140B Q4(速度较慢) 推荐模型:DeepSeek-R1-70B、医学 / 地质垂类大模型;支持医学影像 RAG、地质勘探知识库问答。
✅落地提示:双 64G 显存合计,可并行处理三维渲染与大模型推理;512G ECC 内存保障长时间仿真与训练稳定性,适合医疗、BIM 外业现场部署。
5.2 Pmax650GD 230640-MCD|¥259,000
硬件配置:2×AMD 霄龙 7773X(合计 128 核,3.0~3.5GHz,768MB 超大 L3 缓存)|2×RTX PRO 5000 48GB(合计 96GB 显存)|640GB DDR4 ECC|4TB NVMe|双屏 17" 4K 便携工作站(2000W)
核心定位:千架无人机蜂群指挥中枢,面向蜂群实时协同控制、战场态势三维重建、电磁频谱监测、应急调度指挥场景。
表格
| 业务负载 | 场景说明 |
|---|---|
| 千架级无人机蜂群实时协同控制、集群路径规划 | 128 核 + 超大 L3 缓存,并行解算上千架无人机航迹,实时调整集群协同策略,低延迟响应任务指令 |
| 战场态势三维重建、电磁频谱监测分析、应急通信指挥 | 双屏分别显示蜂群态势地图、频谱监测面板;双 48G 显存承载三维战场场景渲染与频谱 AI 识别 |
本地大模型推理能力 GPU 流畅:70B Q8_0 高质量流畅,140B Q4_K_M 双卡并行流畅;CPU 内存可卸载 140B Q8 推荐模型:Qwen2.5-140B、蜂群指挥垂类大模型;支持集群方案推演、电磁信号特征识别 RAG。
✅落地提示:大缓存 + 128 核完美适配蜂群海量并发任务,96G 总显存可同时运行三维渲染与 70B 大模型,双屏适配外业指挥场景。
5.3 Pmax660G 234512-MCF|¥350,000
硬件配置:2×AMD 霄龙 9654(合计 192 核,3.4~3.7GHz)|RTX PRO 6000 96GB|512GB DDR5 ECC|4TB NVMe|17" 4K 便携超算(2600W)
核心定位:192 核 AI 大模型训练 + 科学计算平台,面向移动式大模型训练中心、石油勘探深度偏移、气象数值预报、蛋白质分子动力学模拟场景。
表格
| 业务负载 | 场景说明 |
|---|---|
| 移动式大模型训练、行业垂类模型 LoRA 微调 | 192 核 CPU 负责数据预处理,RTX PRO6000 96G 大显存支持百亿级模型微调,野外即可完成行业小模型训练 |
| 石油勘探深度偏移、气象数值预报、蛋白质分子动力学模拟 | 512G 内存承载勘探数据、气象格点数据集,双路 CPU 并行求解偏微分方程,离线完成科学仿真计算 |
本地大模型推理能力 GPU 流畅:140B Q4_K_M 流畅,70B Q8_0 高质量流畅;CPU 内存可卸载 405B Q4(仅原型验证) 推荐模型:Qwen2.5-140B、石油 / 气象 / 生物垂类大模型;支持科研文档 RAG、分子结构 AI 预测。
✅落地提示:单卡 96G 显存部署简单,192 核并行算力强,兼顾大模型训练与科学仿真,适合科研院所野外离线超算场景。
5.4 Pmax660G 2411T768-MDH|¥499,990
硬件配置:2×AMD 霄龙 9A85(合计 192 核,4.1~4.5GHz 高频水冷)|2×RTX PRO 5000 72GB(合计 144GB 显存)|640GB DDR5 ECC|8TB NVMe|三屏 17" 4K 便携超算(2600W)
核心定位:万亿参数大模型训练怪兽,面向核物理蒙特卡洛仿真、超大规模 CFD 计算、实时战略战役推演场景。
表格
| 业务负载 | 场景说明 |
|---|---|
| 核物理蒙特卡洛仿真、超大规模 CFD 流体计算 | 192 核高频 CPU 并行求解海量粒子轨迹、流体网格迭代,三屏分别显示仿真结果云图、参数面板、AI 分析报告 |
| 实时战略战役推演、亿级参数大模型训练 | 双 72G 显存合计 144G,双卡张量并行支持万亿参数模型量化训练,640G 内存承载仿真数据集与模型权重 |
本地大模型推理能力 GPU 流畅:140B Q8_0 高质量流畅,405B Q4_K_M 双卡张量并行推理 推荐模型:DeepSeek-V3、Qwen2.5-140B、核物理 / 军事垂类超大模型;支持百万 Token 超长上下文、多 Agent 集群协同推演。
✅落地提示:高频 192 核 + 144G 总显存,兼顾科学仿真与超大模型训练推理,三屏适配指挥推演场景,是便携式异构超算的主力配置。
5.5 Pmax660GT 2411T-MDF|¥590,000
硬件配置:2×AMD 霄龙 9755(合计 256 核,4.1GHz)|2×RTX PRO 6000 96GB(合计 192GB 显存)|768GB DDR5 ECC|8TB NVMe|三屏 17" 4K 便携旗舰(2000W)
核心定位:256 核至尊 AI 超算旗舰,面向国家级密码破译、基因测序比对、超高清城市级三维重建、AI 大模型边缘训练中心场景。
表格
| 业务负载 | 场景说明 |
|---|---|
| 国家级密码破译、基因测序海量序列比对 | 256 核极致多核并行,批量处理哈希破解、基因序列比对任务,768G 超大内存承载海量测序数据集 |
| 超高清城市级三维重建、AI 大模型边缘训练 | 双 96G 合计 192G 显存,支持城市级实景三维渲染与 400B 级大模型离线训练,三屏分别显示三维模型、数据面板、AI 训练监控 |
本地大模型推理能力 GPU 流畅:140B Q8_0 流畅,405B Q4_K_M 双卡并行流畅;CPU 内存可卸载 405B Q8 推荐模型:Qwen2.5-140B、DeepSeek-V3、基因 / 密码垂类超大模型;支持千万级基因序列 RAG、密码分析知识库。
✅落地提示:256 核 + 192G 总显存 + 768G 内存,是便携工作站的算力天花板,单机即可替代小型机房超算集群,适合绝密离线边缘部署。
Pmax 系列大模型推理能力总览表
表格
| 方案 | 型号 | 双路 CPU / 总核心 | 双 GPU / 总显存 | 内存 | GPU 推理上限 | CPU 内存推理上限 | 推荐模型 |
|---|---|---|---|---|---|---|---|
| 5.1 | Pmax650GD 238512-MCC | 2×75F3 /64 核 | 2×RTX PRO4500 32G(64G) | 512GB DDR4 | 70B Q4 双卡并行;32B Q8 | 140B Q4 (慢) | DeepSeek-R1-70B、医学垂类模型 |
| 5.2 | Pmax650GD 230640-MCD | 2×7773X /128 核 | 2×RTX PRO5000 48G(96G) | 640GB DDR4 | 140B Q4 双卡并行;70B Q8 | 140B Q8 | Qwen2.5-140B、蜂群指挥模型 |
| 5.3 | Pmax660G 234512-MCF | 2×9654 /192 核 | RTX PRO6000 96G | 512GB DDR5 | 140B Q4;70B Q8 | 405B Q4 (原型) | Qwen2.5-140B、石油 / 气象模型 |
| 5.4 | Pmax660G 2411T768-MDH | 2×9A85 /192 核 | 2×RTX PRO5000 72G(144G) | 640GB DDR5 | 405B Q4 双卡并行;140B Q8 | 405B Q4 | DeepSeek-V3、核物理仿真模型 |
| 5.5 | Pmax660GT 2411T-MDF | 2×9755 /256 核 | 2×RTX PRO6000 96G(192G) | 768GB DDR5 | 405B Q4 双卡并行;140B Q8 | 405B Q8 | 基因 / 密码垂类超大模型 |
软件部署环境
操作系统
- Windows 11 Pro For Workstations:三维渲染、BIM、GIS 可视化软件适配
- Ubuntu 22.04 LTS:AI 训练推理、多 GPU 并行计算、科学仿真、vLLM 高吞吐部署首选
- 支持离线定制安全加固系统,满足涉密场景分级保护要求
AI 工具链
Ollama / LM Studio(快速模型测试),vLLM(生产级高吞吐推理),PyTorch+CUDA,NCCL 多卡通信库,Megatron-LM 多卡模型并行训练框架,Docker 容器化部署 RAG、多 Agent 服务。
行业专业软件
科学仿真类:GROMACS(分子动力学)、ANSYS Fluent(CFD)、蒙特卡洛仿真平台; 石油勘探类:地震数据反演、深度偏移处理软件; 军事指挥类:蜂群仿真、电磁频谱监测、战役推演平台; 生物信息类:基因测序比对、序列分析工具集。
常见问题
Q1:双路 CPU 便携工作站,相比单路 CPU 做超算有什么优势? A:双路 CPU 核心数翻倍、内存通道翻倍,海量数据预处理、多源并行仿真、多路任务调度能力大幅提升;同时支持 PCIe 通道翻倍,双 GPU 之间通信带宽更高,模型并行延迟更低,适合大模型训练、科学仿真这类多核密集负载。
Q2:双 GPU 跑大模型,模型并行和数据并行怎么选? A:模型并行:把单个超大模型拆分到多张 GPU,加载单卡显存放不下的百亿 / 万亿级模型,适合大模型训练、超大参数推理;数据并行:每张 GPU 加载相同模型,处理不同批次数据,提升批量推理吞吐,适合高并发在线服务。Pmax 系列同时支持两种并行模式。
Q3:为什么这个系列全部采用 ECC 内存? A:ECC 内存可自动纠正运行时比特错误,7×24 小时长时间跑科学仿真、大模型训练、密码破译这类高负载任务时,避免内存偶发错误导致的计算结果偏差、程序崩溃,满足科研、军事、医疗场景对数据精度与稳定性的极端要求。
Q4:便携双路超算工作站,野外离线部署供电有什么要求? A:全系支持 220V 市电 + 大功率 UPS 双供电,满载功耗 2000~2600W,野外可搭配移动发电机组使用;整机做散热加固,-10℃~45℃环境可正常运行,不需要机房环境,车载、野战环境可独立工作。
Q5:RTX PRO 专业卡,做 AI 训练相比消费级显卡有什么区别? A:RTX PRO 专业卡显存更大、支持 ECC 显存纠错、PCIe 通道数更多、7×24 小时满载稳定性经过工业认证;适合长时间离线训练、高精度科学计算场景;消费卡同价位算力更高,但稳定性、显存纠错能力弱,不适合长时间不间断训练任务。
Q6:这个系列可以完全离线、不连外网部署大模型训练环境吗? A:全部机型支持完全离线部署,CUDA 环境、框架、模型权重、行业软件全部预装在本地硬盘,不需要连接外网即可完成模型训练、推理、仿真计算,数据完全不出本机,满足绝密场景物理隔离要求。
选型建议
表格
| 业务目标 | 推荐型号 | 选型理由 |
|---|---|---|
| 大型三维渲染、医学影像 AI 训练、BIM 审查 | 5.1 | 64 核 + 双 32G 显存,512G 内存,平衡渲染与轻量 AI 训练需求 |
| 千架无人机蜂群指挥、电磁频谱监测 | 5.2 | 128 核大缓存 + 双 48G 显存,双屏适配指挥场景,集群并行计算能力强 |
| 石油勘探、气象预报、蛋白质动力学模拟 + 大模型训练 | 5.3 | 192 核单 96G 显存,部署简单,兼顾科学仿真与百亿级模型训练 |
| 核物理仿真、CFD 计算、战役推演 + 万亿模型训练 | 5.4 | 192 核高频 + 双 72G 合计 144G 显存,三屏指挥,支持 400B 级模型推理 |
| 密码破译、基因测序、城市级三维重建超大边缘超算 | 5.5 | 256 核 + 双 96G 合计 192G 显存 + 768G 内存,便携超算算力天花板 |
UltraLAB 服务:Pmax 系列双路便携超算工作站,提供系统深度定制、多 GPU 通信调优、行业软件预装、大模型训练环境预部署;支持涉密安全加固、野外环境适应性改造,提供三年硬件质保 + 7×24 小时专项技术支持。


