






title: "UltraLAB AlphaPro660 超级图形工作站应用场景详解:双路 192–256 核旗舰平台 + 70B–671B 大模型推理全解析"
双路 192–256 核旗舰平台:从数值模拟到 671B 大模型私有化部署
当算力需求突破天际,UltraLAB AlphaPro660 以双路 AMD 霄龙 192–256 核、512GB–1.5TB 海量内存、RTX 5090 至 H200 数据中心级 GPU 的极致组合,重新定义桌面超算的边界。本文深度解析 AlphaPro660 系列 7 款旗舰配置——从 ¥33 万的大型数值模拟平台到 ¥100 万的"地球最强"异构超算,覆盖数学规划、超大规模有限元、多物理场耦合、共享虚拟超算到 70B–671B 大模型本地部署。
目录
一、系列概览:AlphaPro660 的旗舰定位
AlphaPro660 是 UltraLAB 工作站产品线的绝对旗舰,与 A350/GR450P/EA650/GX660M 系列形成金字塔式互补:
| 对比维度 | A350 系列 | GR450P 系列 | EA650 系列 | GX660M 系列 | AlphaPro660 |
|---|---|---|---|---|---|
| 定位 | 个人/小团队 | 专业工程师 | 科学计算 | 多卡 GPU 超算 | 旗舰超算中心 |
| CPU | 14–24 核桌面 | 20–96 核 | 双路 64–256 核 | 双路 64 核 | 双路 192–256 核 |
| 内存 | 32–128GB | 64–384GB | 192–768GB | 256GB–1TB | 512GB–1.5TB |
| GPU | RTX 5060–5090 | RTX 5080–A100 | RTX 5060Ti–5080 | 2–4 卡 L20/4090/A100/H200 | RTX 5090 / H200 单卡旗舰 |
| 总显存 | 8–48GB | 12–80GB | 16–48GB | 96–564GB | 32–141GB |
| 机箱 | 塔式 | 塔式/双塔 | 双塔 | 双塔 | 双塔式 + 双 2000–2600W 电源 |
| 价格 | ¥2–10 万 | ¥9–40 万 | ¥9–42 万 | ¥14–115 万 | ¥33–100 万 |
核心认知:AlphaPro660 并非简单堆料,而是针对"内存饥渴型"和"算力极致型"场景的精准打击——512GB–1.5TB 内存可加载传统平台无法触及的模型规模,双路 256 核 4.1GHz 提供准超算级 CPU 算力,H200 141GB 则是目前单卡显存之王。
二、七款配置详解与应用场景
2.1 方案一:AlphaPro660 234512-MCT | 大型数值模拟超级工作站
¥330,000 | 2×AMD 霄龙 9684X (192核 3.5GHz, 超大缓存) / 512GB DDR5 / RTX 5090 32GB + 水冷 / 双塔式(双2000W)
核心定位
数值模拟与大数据统计分析的旗舰入口——双路 192 核 3.5GHz + 512GB 内存 + RTX 5090 32GB,以 ¥33 万价位提供准超算级算力。
详细应用场景
| 场景 | 具体工作负载 | 能力说明 |
|---|---|---|
| 数学规划 | 大规模线性规划(LP)、混合整数规划(MIP)、二次规划(QP)求解 | 192 核并行加速稀疏矩阵分解,512GB 内存加载千万变量级优化问题 |
| 数值模拟 | 偏微分方程数值解(有限差分/有限体积)、谱方法、粒子方法 | 超大 L3 缓存减少内存访问延迟,双路内存带宽 400GB/s+ |
| 蒙特卡洛算法 | 金融衍生品定价(期权定价、风险价值 VaR)、物理随机过程模拟 | 192 核并行生成百万级随机路径,GPU 加速路径计算 |
| 期权定价建模 | Black-Scholes、Heston 模型、局部波动率模型的大规模校准 | RTX 5090 加速蒙特卡洛模拟中的路径依赖计算 |
| 大数据统计分析 | R/Python 十亿级数据点统计建模、Spark 单机内存计算、大规模回归分析 | 512GB 内存可加载 50GB+ 数据集全内存处理 |
AI 大模型推理能力
| 推理方式 | 支持模型 | 速度/说明 |
|---|---|---|
| GPU 推理 | 32B Q4 (流畅)、32B Q8 (接近上限) | ~20–35 token/s (RTX 5090) |
| GPU + CPU offloading | 70B Q4 (~43GB,部分层 offloading 到 512GB 内存) | ~5–10 token/s |
| CPU 内存推理 | 70B Q4/Q8 (512GB 内存充裕)、可尝试 70B FP16 (~140GB,需内存优化) | ~8–15 token/s (192 核并行) |
典型用户画像
- 头部量化私募策略研究部(期权定价、风险建模)
- 高校计算数学/金融工程系
- 国家统计局/大型咨询公司数据分析中心
- 气象数值预报团队
2.2 方案二:AlphaPro660 345640-MCT | 超级科学计算图形工作站
¥420,000 | 2×AMD 霄龙 9575F (128核 4.5GHz) / 640GB DDR5 / RTX 4090 48GB / 4TB NVME(7GB/s) / 双塔式(双2000W)
核心定位
超大规模有限元与多物理场耦合的频率极致平台——128 核 4.5GHz 超高频 + 640GB 内存 + RTX 4090 48GB,在结构/电磁/流体耦合仿真中追求频率与内存的完美平衡。
详细应用场景
| 场景 | 具体工作负载 | 能力说明 |
|---|---|---|
| 超大规模有限元完整型 | ANSYS 整机级装配体(>1 亿单元)、Abaqus 整车碰撞、Nastran 整机模态 | 640GB 内存加载完整飞机/汽车有限元模型,4.5GHz 高频加速约束求解 |
| 结构仿真 | 桥梁全桥静力分析、大坝抗震分析、高层建筑风振响应 | 双路 128 核并行加速大型刚度矩阵迭代 |
| 电磁仿真 | 整机电磁兼容(EMC)分析、雷达散射截面(RCS)计算、微波器件优化 | RTX 4090 48GB 加载千万级网格电磁模型 |
| 流体仿真 | 飞机全机气动分析、发动机内流场 LES 模拟、城市风环境 CFD | 640GB 内存支撑亿级网格的 CFD 全内存求解 |
| 多物理场耦合 | 流固耦合(FSI)、热电耦合、电磁-热耦合、压电耦合 | 4.5GHz 高频减少耦合迭代总时间 |
AI 大模型推理能力
| 推理方式 | 支持模型 | 速度/说明 |
|---|---|---|
| GPU 推理 | 70B Q4 (~43GB,48GB 显存刚好够)、32B Q8 (流畅) | ~10–20 token/s (RTX 4090) |
| CPU 内存推理 | 70B Q4/Q8/FP16 (640GB 内存充裕)、可尝试 140B Q4 | ~6–12 token/s (128 核 4.5GHz) |
亮点:4.5GHz 是全系最高双路频率,CPU 推理速度在双路平台中领先。640GB 内存可完整加载 70B FP16(140GB),实现无精度损失的科研级推理。
典型用户画像
- 航空主机厂强度室主任
- 汽车碰撞安全首席工程师
- 大型桥梁设计院技术总监
- 核电设备仿真团队
2.3 方案三:AlphaPro660 242640-MCD | 有限元分析超级小型计算机
¥450,000 | 2×AMD 霄龙 9A85 (192核 4.2GHz) / 640GB DDR5 / RTX Pro 5000 72GB / 4TB NVME / 双塔式(双2000W)
核心定位
"最快的超大规模有限元计算"专用平台——192 核 4.2GHz + 640GB 内存 + RTX Pro 5000 72GB,在结构动态、电磁、流体、冲击爆炸、蒙特卡洛五大领域追求极致速度。
详细应用场景
| 场景 | 具体工作负载 | 能力说明 |
|---|---|---|
| 结构动态仿真 | LS-DYNA 整车碰撞(>5000 万单元)、Abaqus/Explicit 高速冲击、金属成形 | 192 核 + 4.1GHz 高频缩短显式算法时间步长计算 |
| 电磁仿真 | CST 十亿级网格时域仿真、整机天线布局优化、电磁脉冲防护 | RTX Pro 5000 72GB 加载大型电磁模型,FP64 双精度保障精度 |
| 流体仿真 | 爆炸冲击波传播(AUTODYN)、多相流搅拌器模拟、燃烧室 CFD | 640GB 内存加载包含化学反应的复杂流体模型 |
| 冲击爆炸仿真 | 穿甲弹侵彻模拟、建筑物爆炸倒塌、矿山爆破优化 | 显式动力学天然并行,192 核近线性扩展 |
| 蒙特卡洛 | 核反应堆物理模拟、辐射输运、金融极端风险建模 | 超大内存加载精细化的蒙特卡洛粒子追踪网格 |
AI 大模型推理能力
| 推理方式 | 支持模型 | 速度/说明 |
|---|---|---|
| GPU 推理 | 70B Q4 (~43GB,72GB 显存充裕)、70B Q8 (~78GB,接近上限) | ~12–20 token/s (RTX Pro 5000) |
| CPU 内存推理 | 70B FP16 (640GB 内存充裕)、140B Q4 (~280GB,可尝试) | ~10–18 token/s (192 核并行) |
Pro 5000 优势:72GB ECC 显存 + FP64 双精度 10 TFLOPS + ISV 认证,是电磁/结构仿真工程师的"梦中情卡"。
典型用户画像
- 军工单位爆炸防护研究所
- 核工业设计院反应堆物理室
- 汽车主机厂安全性能总监
- 航空航天冲击动力学专家
2.4 方案四:AlphaPro660 242768-MCF | 超大规模仿真高性能平台
¥515,000 | 2×AMD 霄龙 9A85 (192核 4.2GHz) / 768GB DDR5 / RTX Pro 6000 96GB / 4TB NVME(7GB/s) / 双塔式(双2000W)
核心定位
电子电力与多物理场耦合的 96GB 显存旗舰——768GB 内存 + RTX Pro 6000 96GB,在电力系统仿真、电磁兼容、虚拟超算领域实现"仿真 + AI"的深度融合。
详细应用场景
| 场景 | 具体工作负载 | 能力说明 |
|---|---|---|
| 电子与电力系统仿真 | PSCAD 大规模电网电磁暂态、ETAP 潮流与短路计算、电力电子开关仿真 | 192 核并行加速电力系统微分代数方程求解 |
| 电磁仿真 | 变电站电磁环境评估、高压设备绝缘优化、无线充电系统仿真 | RTX Pro 6000 96GB 加载千万级网格电力设备模型 |
| 多物理场耦合 | 变压器电热磁耦合、电机电磁-热-结构耦合、电缆载流量优化 | 768GB 内存支撑多物理场网格的联合求解 |
| 共享/虚拟超级计算平台 | 3–5 人远程桌面同时使用 ANSYS/COMSOL/ETAP | 768GB 内存通过虚拟化分配给各用户会话 |
AI 大模型推理能力
| 推理方式 | 支持模型 | 速度/说明 |
|---|---|---|
| GPU 推理 | 70B Q4 (充裕)、70B Q8 (~78GB,96GB 显存流畅)、32B FP16 | ~15–25 token/s (RTX Pro 6000) |
| CPU 内存推理 | 70B FP16 (768GB 内存充裕)、140B Q4 (~280GB,可加载) | ~10–18 token/s (192 核并行) |
| 多模型并发 | GPU 跑 70B Q8 + CPU 跑 32B Q4 | 768GB 内存支撑双模型同时驻留 |
典型用户画像
- 国家电网仿真中心高级工程师
- 南方电网电力科学研究院
- 大型变压器厂研发总监
- 新能源逆变器公司技术 VP
2.5 方案五:AlphaPro660 241768-MCA | 大型多用途仿真计算平台
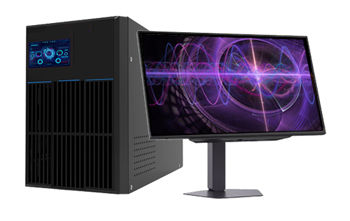
¥499,900 | 2×AMD 霄龙 9755 (256核 4.1GHz) / 768GB DDR5 / RTX A1000 + A100 80GB + 水冷 / 4TB NVMe(7GB/s) / 双塔式(双2000W)
核心定位
共享虚拟超级计算平台——256 核 4.1GHz + 768GB 内存 + A100 80GB 数据中心级计算卡,为团队提供"超算即服务"。
详细应用场景
| 场景 | 具体工作负载 | 能力说明 |
|---|---|---|
| 共享/虚拟超级计算平台 | 5–8 人远程桌面同时运行 CAE/CFD/AI 任务,各分配 32–64 核 + 96GB 内存 | 768GB 内存通过 VMware/KVM 虚拟化隔离 |
| 有限元分析 | ANSYS 整机级装配体、ABAQUS 大型非线性分析、LS-DYNA 多工况批量计算 | 256 核并行加速批量仿真任务 |
| 量子化学 | VASP 大体系 DFT、Gaussian 高精度能量计算、ORCA 耦合簇计算 | A100 的 FP64 双精度加速量子化学矩阵运算 |
| 分子动力模拟 | GROMACS 千万原子体系、NAMD 大规模并行 MD、蛋白质-配体对接 | A100 的 Tensor Core 加速分子间作用力计算 |
| 电磁仿真 | CST 时域/频域求解、HFSS 大规模天线阵列 | 80GB 显存加载千万级网格电磁模型 |
| 深度学习训练 | LLaMA-3 70B LoRA 微调、AlphaFold2 批量训练、多模态模型预训练 | A100 的 Tensor Core + NVLink 加速混合精度训练 |
AI 大模型推理能力
| 推理方式 | 支持模型 | 速度/说明 |
|---|---|---|
| GPU 推理 (A100 80GB) | 70B Q4 (~43GB,80GB 显存充裕)、70B Q8 (~78GB,可尝试)、支持长上下文 (128K+) | ~12–20 token/s (A100) |
| CPU 内存推理 | 70B FP16 (768GB 内存充裕)、140B Q4 (~280GB,可加载) | ~12–20 token/s (256 核并行) |
| 多用户共享推理 | 5 用户各跑 14B–32B 模型(vGPU 分区) | A100 MIG 技术可切分为 7 个 10GB 实例 |
A100 特性:第三代 Tensor Core、80GB HBM2e 显存、支持 MIG(多实例 GPU)、数据中心级 ECC 可靠性,是共享平台的首选。
典型用户画像
- 高校高性能计算中心管理员
- 科研院所共享计算平台负责人
- 大型设计院仿真中心 IT 架构师
- 制药公司计算化学团队
2.6 方案六:AlphaPro660 2411T-MCH | 海量数据处理图形服务器
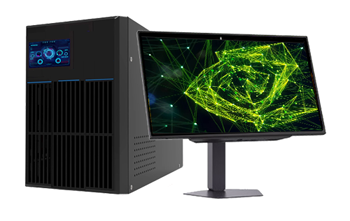
¥670,000 | 2×AMD 霄龙 9755 (256核 4.1GHz) / 1TB DDR5 / RTX A2000 + H100 80GB + 水冷 / 4TB NVME / 双塔式(双2000W)
核心定位
地震、海洋、视频、生物信息的 1TB 内存数据怪兽——256 核 4.1GHz + 1TB 内存 + H100 80GB,专为 PB 级数据处理和 AI 训练设计。
详细应用场景
| 场景 | 具体工作负载 | 能力说明 |
|---|---|---|
| 海量数据处理 | 地震资料处理(>10TB 地震道集)、海洋资料同化、卫星遥感数据融合 | 1TB 内存缓存 TB 级数据子集,256 核并行加速信号处理 |
| 视频结构化智能分析 | 城市级视频监控实时分析、行为识别、车辆轨迹追踪 | H100 的 Transformer Engine 加速视频理解模型 |
| 生物信息学分析 | 全基因组关联分析(GWAS)、单细胞 RNA 测序、蛋白质组学大数据 | 1TB 内存加载 entire 基因组变异矩阵 |
| 科学计算 | 气候模式百年积分、宇宙学 N 体模拟(十亿粒子)、核反应堆物理 | H100 FP8 精度加速 AI+HPC 融合负载 |
| AI 大模型训练 | GPT-4 级别模型预训练、多模态大模型(图文音视频)训练、RLHF 强化学习 | H100 的 FP8 Transformer Engine 训练速度比 A100 快 2–3 倍 |
AI 大模型推理能力
| 推理方式 | 支持模型 | 速度/说明 |
|---|---|---|
| GPU 推理 (H100 80GB) | 70B Q4 (充裕)、70B Q8 (接近上限 ~78GB)、支持 FP8 推理加速 | ~15–25 token/s (H100,FP8 加速) |
| CPU 内存推理 | 140B Q4 (~280GB,1TB 内存充裕)、70B FP16 (有余量) | ~12–20 token/s (256 核并行) |
| 训练能力 | 70B 全参数 LoRA、14B 全参数微调、多模态预训练 | H100 FP8 是训练 70B+ 模型的甜点配置 |
H100 特性:Hopper 架构,80GB HBM3 显存(带宽 3.35TB/s),第四代 Tensor Core,FP8 Transformer Engine,目前训练大模型的性价比之王。
典型用户画像
- 中国地震局数据处理中心
- 国家海洋信息中心
- 大型基因测序公司(华大基因级别)
- 头部 AI 公司训练基础设施团队
2.7 方案七:AlphaPro660 T1 | 超级异构图形工作站
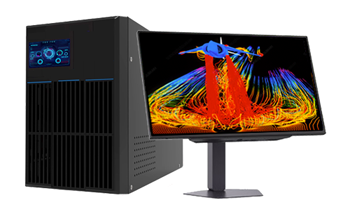
¥999,900 | 2×AMD 霄龙 9755 (256核 4.1GHz) / 1.5TB DDR5 / RTX A4000 + H200 141GB + 水冷 / 8TB NVME(14GB/s) / 双塔式(双2200W)
核心定位
"地球最强大高性能计算平台"——双路 256 核 4.1GHz + 1.5TB 内存 + H200 141GB 单卡显存之王,双 2200W 电源 + 8TB NVMe,单台算力触及桌面超算的理论极限。
详细应用场景
| 场景 | 具体工作负载 | 能力说明 |
|---|---|---|
| 科学计算 | 宇宙学 N 体模拟(百亿粒子)、气候模式全耦合积分、核聚变等离子体模拟 | 256 核 + 1.5TB 内存提供准 E 级超算入门算力 |
| 图形生成 | 超大规模科学可视化(十亿网格实时漫游)、数字孪生城市级渲染、NeRF/3D Gaussian Splatting | H200 141GB 显存加载整个城市的神经辐射场 |
| 图像处理 | 卫星影像超分辨率(TB 级)、医学影像 AI 诊断(百万张 CT)、工业缺陷检测 | 1.5TB 内存缓存百万级图像数据集 |
| 可视化 | ParaView 十亿网格交互式探索、VTK 超大规模体绘制、Cesium 全球数字孪生 | RTX A4000 驱动专业可视化,H200 加速计算 |
| 大数据 | Spark/Dask 单机 PB 级分析、ClickHouse 实时数仓、图神经网络(十亿节点) | 1.5TB 内存支撑十亿节点图的全内存计算 |
| AI 大模型 | 671B 超大模型私有化部署、GPT-4 级别模型服务、多 Agent 智能体集群 | 详见下方 AI 能力分析 |
AI 大模型推理能力(全系最强)
| 推理方式 | 支持模型 | 速度/说明 |
|---|---|---|
| GPU 推理 (H200 141GB) | 70B Q4 (非常充裕)、70B Q8 (~78GB,流畅)、70B FP16 (~140GB,刚好够)、140B Q4 (~280GB,需 CPU offloading) | ~20–35 token/s (70B) / ~5–10 token/s (140B offloading) |
| CPU 内存推理 | 671B Q4 (~400GB,1.5TB 内存可加载!)、140B Q8 (~560GB,可尝试)、70B FP16 (有余量) | ~3–8 token/s (671B,256 核) / ~8–15 token/s (140B) |
| 多模型并发 | GPU 跑 70B FP16 + CPU 跑 671B Q4 + 后台跑 5×14B | 1.5TB 内存 + 141GB 显存的极致资源池 |
| 训练能力 | 671B 模型 LoRA 微调(需 ZeRO-3 + CPU offloading)、70B 全参数微调、多模态大模型预训练 | H200 的 141GB 显存 + 1.5TB 内存是训练 671B 模型的最低桌面配置 |
H200 特性:Hopper 架构升级版,141GB HBM3e 显存(带宽 4.8TB/s),目前单卡显存容量之王。配合 1.5TB 内存,可实现:
- GPU 端:70B FP16 原始精度推理(无精度损失)
- CPU 端:671B Q4 量化模型加载(400GB 权重 + 200GB 上下文缓存)
- 这是目前桌面级平台能触及的最大模型规模。
典型用户画像
- 国家级实验室首席科学家(宇宙学/核物理/气候学)
- OpenAI/Anthropic 级别大模型公司基础设施负责人
- 头部量化私募 AI 研究部(策略大模型)
- 国家气象局数值预报中心
- 顶级科研院所(中科院/工程院院士团队)
三、AI 大模型推理能力对照表 { #section-ai-deployment}
3.1 全系 7 款配置大模型推理能力总表
| 方案 | 型号 | 价格 | CPU | 显卡 | 显存 | 内存 | GPU 推理上限 | CPU 内存推理上限 | 核心用途 |
|---|---|---|---|---|---|---|---|---|---|
| 1 | 234512-MCT | ¥330,000 | 2×9684X 192核 3.5GHz | RTX 5090 | 32GB | 512GB DDR5 | 32B Q4 / 70B Q4(offload) | 70B Q4/Q8 / 70B FP16(尝试) | 数值模拟/蒙特卡洛/大数据分析 |
| 2 | 345640-MCT | ¥420,000 | 2×9575F 128核 4.5GHz | RTX 4090 | 48GB | 640GB DDR5 | 70B Q4 (~43GB 刚好够) | 70B FP16 (640GB 充裕) | 超大规模有限元/多物理场耦合 |
| 3 | 241640-MCD | ¥450,000 | 2×9A85 192核 4.2GHz | RTX Pro 5000 | 72GB | 640GB DDR5 | 70B Q4 (充裕) / 70B Q8 (接近上限) | 70B FP16 / 140B Q4 (尝试) | 结构动态/冲击爆炸/电磁/流体 |
| 4 | 241768-MCF | ¥515,000 | 2×9A85 192核 4.2GHz | RTX Pro 6000 | 96GB | 768GB DDR5 | 70B Q8 (~78GB 流畅) / 32B FP16 | 70B FP16 / 140B Q4 | 电力系统/多物理场耦合/共享平台 |
| 5 | 241768-MCA | ¥499,900 | 2×9755 256核 4.1GHz | A100 | 80GB | 768GB DDR5 | 70B Q4 (充裕) / 长上下文 / MIG 多实例 | 70B FP16 / 140B Q4 | 共享虚拟超算/量子化学/分子动力 |
| 6 | 2411T-MCH | ¥670,000 | 2×9755 256核 4.1GHz | H100 | 80GB | 1TB DDR5 | 70B Q4 / FP8 加速 / 训练优化 | 140B Q4 (~280GB) / 70B FP16 | 地震/海洋/视频/生物信息学 |
| 7 | T1 | ¥999,900 | 2×9755 256核 4.1GHz | H200 | 141GB | 1.5TB DDR5 | 70B FP16 (~140GB 刚好够) / 70B Q8 (流畅) | 671B Q4 (~400GB 可加载!) / 140B Q8 | 地球最强超算/671B 模型/国家级项目 |
3.2 推理速度参考
| 模型 | 平台 | 量化/精度 | 速度 (token/s) | 说明 |
|---|---|---|---|---|
| 32B Q4 | RTX 5090 32GB | Q4_K_M | 20–35 | 方案 1 GPU 实时交互 |
| 70B Q4 | RTX 4090 48GB | Q4_K_M | 10–20 | 方案 2 GPU 刚好够 |
| 70B Q8 | RTX Pro 6000 96GB | Q8_0 | 15–25 | 方案 4 GPU 高质量推理 |
| 70B Q4 | A100 80GB | Q4_K_M | 12–20 | 方案 5 GPU 数据中心级 |
| 70B FP8 | H100 80GB | FP8 | 20–35 | 方案 6 GPU 训练/推理双优 |
| 70B FP16 | H200 141GB | FP16 | 15–25 | 方案 7 GPU 原始精度 |
| 70B FP16 | 256 核 + 1TB 内存 | FP16 | 8–15 | 方案 6 CPU 内存推理 |
| 140B Q4 | 256 核 + 1TB 内存 | Q4_K_M | 3–8 | 方案 6/7 CPU 超大模型 |
| 671B Q4 | 256 核 + 1.5TB 内存 | Q4_K_M | ~2–5 | 方案 7 CPU 桌面级 GPT-4 |
3.3 从 70B 到 671B:模型规模与硬件匹配
模型规模金字塔(AlphaPro660 系列支撑能力)

                    ┌─────────────┐
                    │   671B Q4                │  ← 方案 7 (T1):1.5TB 内存 CPU 加载
                    │  ~400GB                  │     GPU 无法加载,纯 CPU 推理 ~2–5 token/s
                    └──────┬──────┘
                                  │
                    ┌─────────────┐
                    │   140B Q4                │  ← 方案 6/7:1TB+ 内存 CPU 加载
                    │  ~280GB                  │     或方案 7 H200 GPU offload
                    └──────┬──────┘
                                  │
                    ┌─────────────┐
                    │   70B FP16               │  ← 方案 4/5/6/7:768GB+ 内存或 H200 141GB GPU
                    │  ~140GB                  │     原始精度,无量化损失
                    └──────┬──────┘
                                  │
                    ┌─────────────┐
                    │   70B Q8                 │  ← 方案 3/4/5/6/7:72GB+ 显存或 640GB+ 内存
                    │  ~78GB                   │     高质量量化
                    └──────┬──────┘
                                  │
                    ┌─────────────┐
                    │   70B Q4                 │  ← 方案 2/3/5/6/7:48GB+ 显存或 512GB+ 内存
                    │  ~43GB                   │     标准量化,性价比之选
                    └──────┬──────┘
                                  │
                    ┌─────────────┐
                    │   32B Q4                 │  ← 方案 1:RTX 5090 32GB 流畅运行
                    │  ~20GB                   │     所有方案均可轻松驾驭
                    └─────────────┘
四、512GB–1.5TB 内存的 AI 革命 { #section-memory-revolution}
4.1 为什么超大内存是 AI 的下一个战场?
| 趋势 | 说明 | AlphaPro660 的应对 |
|---|---|---|
| 模型规模膨胀 | GPT-4 约 1.8T 参数,GPT-5 预计 10T+ | 1.5TB 内存可加载 671B Q4,为超大模型预留空间 |
| 长上下文需求 | 128K → 1M → 10M token 上下文 | 768GB–1.5TB 内存支撑百万级 token 上下文缓存 |
| 多 Agent 协作 | 5–10 个 Agent 各配独立模型 | 1TB 内存可同时驻留 3×70B + 5×14B |
| 无 offloading 推理 | 避免 CPU-GPU 数据传输延迟 | 模型完全驻留内存或显存,推理效率最大化 |
4.2 内存容量与模型规模的数学关系
| 内存容量 | 可加载最大模型 (CPU) | 可支撑上下文长度 (70B Q4) | 可并发模型数 |
|---|---|---|---|
| 512GB | 70B Q4 (~43GB) + 128K 上下文 | ~64K tokens | 1×70B + 2×14B |
| 640GB | 70B FP16 (~140GB) + 64K 上下文 | ~128K tokens | 1×70B + 4×14B |
| 768GB | 140B Q4 (~280GB) + 32K 上下文 | ~256K tokens | 2×70B + 4×14B |
| 1TB | 140B Q8 (~560GB) + 16K 上下文 | ~512K tokens | 3×70B + 5×14B |
| 1.5TB | 671B Q4 (~400GB) + 128K 上下文 | ~1M tokens | 1×671B + 2×70B + 5×14B |
4.3 方案 7(T1)的 671B 推理实战
场景:某国家级 AI 实验室需本地化部署 DeepSeek-R1 671B 模型,用于涉密文档分析与政策研究。
硬件配置:AlphaPro660 T1
├── CPU:2×霄龙 9755 (256核 4.1GHz)
├── 内存:1.5TB DDR5
├── GPU:H200 141GB(显示:RTX A4000)
└── 存储:双 8TB NVMe (14GB/s) + 20TB SATA

模型部署:671B Q4_K_M 量化
├── 模型权重:~400GB
├── 上下文缓存:~200GB(128K tokens)
├── KV Cache:~300GB
└── 系统预留:~100GB
    总计:~1TB(1.5TB 内存充裕)

推理性能:
├── 预填充(Prefill):~50 tokens/s(256 核并行处理 prompt)
├── 解码(Decode):~2–5 tokens/s(内存带宽瓶颈)
├── 并发:支持 3–5 人同时查询(各分配 64K 上下文)
└── 适用:后台文档分析、批量报告生成、政策研究辅助

对比云端 API:
├── 数据安全:完全本地,无出境风险 ✅
├── 成本:一次性 ¥100 万 vs 年付 API ¥200 万+
├── 延迟:略慢于云端(2–5 vs 20–50 token/s)
└── 可控性:模型权重、推理逻辑完全可控 ✅
五、常见问题与硬件配置分析 { #section-faq}
5.1 为什么旗舰系列显卡不是 4 卡,而是单卡?
Q:GX660M 有 4×H200,AlphaPro660 T1 只有 1×H200,是不是退步了?
A:不是退步,是定位不同。
- GX660M(多卡):主打 GPU 训练与多卡并行推理,4×H200 通过 NVLink 聚合 564GB 显存,适合训练 70B–140B 模型。
- AlphaPro660(单卡旗舰):主打 "单卡极致 + CPU 内存溢出",H200 141GB 单卡跑 70B FP16,1.5TB 内存跑 671B Q4。CPU 内存成为第二块"显存"。
简单来说:GX660M 是 "GPU 优先",AlphaPro660 是 "CPU 内存优先 + GPU 辅助"。
5.2 双路 256 核的功耗与散热
Q:T1 满载时功耗多少?需要专用机房吗?
A:必须专用机房。
| 组件 | 满载功耗 |
|---|---|
| 2×霄龙 9755 | 700W (350W×2) |
| H200 141GB | 700W |
| RTX A4000 | 140W |
| 内存 (1.5TB DDR5) | 300W |
| 存储 + 风扇 + 其他 | 200W |
| 总计 | ~2040W |
双 2600W 电源提供冗余,但满载时:
- 噪音:60–70 分贝(工厂车间级别)
- 散热:需空调恒温 20–22°C,每小时排出 7000+ BTU 热量
- 电力:需 16A 工业插座,UPS 备份必备
建议:放置于机房,通过远程桌面/SSH 使用。
5.3 512GB 内存和 1.5TB 内存怎么选?
Q:数值模拟选 512GB 还是 1.5TB?
| 需求 | 推荐内存 | 代表方案 | 说明 |
|---|---|---|---|
| 百万级网格 CFD | 512GB | 方案 1 | 标准有限元/CFD 足够 |
| 整车级碰撞(5000 万单元) | 640GB | 方案 2/3 | LS-DYNA 显式动力学 |
| 整机电磁(十亿网格) | 768GB | 方案 4/5 | 电力系统/多物理场 |
| 宇宙学 N 体(十亿粒子) | 1TB | 方案 6 | 粒子模拟内存 hungry |
| 671B 大模型私有化 | 1.5TB | 方案 7 (T1) | 唯一选择 |
5.4 H200 相比 H100 提升多少?
Q:T1 的 H200 比方案 6 的 H100 贵 30 万,值吗?
| 维度 | H100 80GB | H200 141GB | 提升 |
|---|---|---|---|
| 显存容量 | 80GB | 141GB | +76% |
| 显存带宽 | 3.35TB/s | 4.8TB/s | +43% |
| 70B 推理 | Q4 充裕,Q8 接近上限 | Q8 流畅,FP16 刚好够 | 精度升级 |
| 140B 推理 | 不可行 | 可 offload 到 1.5TB 内存 | 规模升级 |
| 训练 | 70B LoRA | 70B 全参数微调 | 能力升级 |
结论:如果业务涉及 70B FP16 原始精度 或 671B 超大模型,H200 是唯一选择。如果仅跑 70B Q4,H100 性价比更高。
5.5 这些配置能替代超算中心吗?
Q:买一台 T1,能替代学校超算中心吗?
A:不能替代,但是最强补充。
| 对比维度 | 国家级超算中心 | AlphaPro660 T1 |
|---|---|---|
| 算力 | E 级(百亿亿次) | ~20 TFLOPS(双精度) |
| 并行规模 | 百万核+ | 256 核 |
| 优势 | 大规模 MPI 并行、国家资助 | 独占使用、零排队、数据安全、AI 友好 |
| 最佳实践 | 千万网格+ 生产任务 | 前期调试、参数扫描、AI 模型服务 |
黄金组合:超算中心跑大规模生产任务,T1 做 调试开发 + AI 推理服务 + 涉密数据处理。
5.6 为什么用霄龙 9755 而不是线程撕裂者?
Q:GR450P 有 7995WX(96核 4.5GHz),AlphaPro660 用 9755(256核 4.1GHz),频率更低?
A:霄龙 9755 是服务器级旗舰,线程撕裂者是桌面级旗舰。
| 维度 | 线程撕裂者 7995WX | 霄龙 9755 |
|---|---|---|
| 核心数 | 96 核 | 256 核 |
| 频率 | 4.5GHz | 4.1GHz |
| 内存通道 | 8 通道 | 12 通道 |
| 最大内存 | 1TB | 1.5TB+ |
| 双路支持 | ❌ 不支持 | ✅ 支持 |
| 企业级特性 | 部分 | 全功能 ECC、RAS、SP5 插槽 |
| 定位 | 桌面极致 | 数据中心/超算中心 |
结论:需要 192–256 核 + 1.5TB 内存时,霄龙是唯一选择。线程撕裂者在单路桌面平台无敌,但无法扩展到双路 256 核。
免责声明:本文基于 UltraLAB 图形工作站基准配置表 2026v1 整理撰写。硬件配置与价格以厂商最新报价为准。CPU 内存推理 671B 大模型的速度受内存带宽、CPU 核心数、量化方案等多因素影响,实际表现可能存在差异(约 1–5 token/s)。671B 模型推理建议以后台批处理为主,不适合实时交互场景。


