






多卡 GPU 超算平台:从 2×L20 到 4×H200,70B–671B 大模型推理全解析
当单卡 48GB 显存触及大模型推理的天花板,多卡 GPU 聚合成为突破极限的必然路径。本文深度解析 UltraLAB GX660M/GX670M 图灵计算工作站 7 款配置——从 2×L20 96GB 到 4×H200 564GB 显存池,覆盖深度学习训练、冷冻电镜重构、电磁仿真、大模型推理服务到 671B 超大模型私有化部署,为你呈现多卡超算平台的完整应用场景与 AI 推理能力指南。
目录
一、系列概览:多卡 GPU 平台的独特定位 { #section-overview}
UltraLAB GX660M/GX670M 系列(图灵计算工作站)与 A350/GR450P/EA650 系列形成鲜明互补:
| 对比维度 | A350/GR450P 系列 | EA650/EX660 系列 | GX660M/GX670M 系列 |
|---|---|---|---|
| GPU 数量 | 1 张 | 1 张(或 1 张专业卡) | 2–4 张 |
| 总显存 | 8–48GB | 16–48GB | 96–564GB |
| GPU 互联 | 无 | 无 | NVLink / NVSwitch |
| CPU | 桌面级 14–128 核 | 双路服务器 64–256 核 | 双路服务器 64 核 |
| 内存 | 32–384GB | 192–768GB | 256GB–1TB |
| 核心优势 | 单核高频 + 均衡 | 超多核 CPU + 海量内存 | 多卡 GPU 聚合显存 + 极致算力 |
| 最佳场景 | 设计 + AI 辅助 | 科学计算、CPU 推理 | 深度学习训练、大模型推理、GPU 仿真 |
关键认知:GX660M/GX670M 系列的核心价值在于 "多卡 GPU 显存聚合"。通过 2–4 张 GPU 的显存池化,可实现单卡无法企及的模型规模——例如 4×H200 的 564GB 显存可加载 671B Q4 量化模型(约 400GB),这是目前消费级/单卡平台完全无法触及的领域。
二、七款配置详解与应用场景 { #section-configs}
2.1 方案一:AE430 135256-MC2L | 全能深度学习工作站
¥142,000 | AMD 霄龙 75F3 (32核 3.5GHz) / 256GB DDR4 / 2×L20 48GB + 水冷 / 塔式(2200W)
核心定位
深度学习与生物计算的入门多卡平台——2×L20 96GB 显存池 + 32 核霄龙,以 ¥14 万价位提供 70B 大模型推理能力。
详细应用场景
| 场景 | 具体工作负载 | 能力说明 |
|---|---|---|
| 深度学习训练 | PyTorch/TensorFlow 中小型模型训练(ResNet-152、ViT-L、BERT-Large)、LoRA 微调(7B–14B LLM) | 2×L20 提供 288 TFLOPS FP32 算力,支持数据并行训练 |
| 冷冻电镜图像重构 | RELION 3D 分类与重构、cryoSPARC 颗粒挑选与精细化 | 96GB 显存可加载大型电镜数据集,GPU 加速重构算法 |
| 蛋白质折叠 | AlphaFold2 结构预测、ColabFold 批量预测、Rosetta 蛋白质设计 | L20 的 Transformer 引擎加速注意力机制计算 |
| AI 大模型推理 | 本地部署 70B Q4 量化模型(DeepSeek-R1 70B)用于科研辅助 | 96GB 显存刚好覆盖 70B Q4(~43GB),支持长上下文 |
AI 大模型推理能力
| 推理方式 | 支持模型 | 速度/说明 |
|---|---|---|
| GPU 多卡推理 | 70B Q4 (96GB 显存刚好够)、32B Q8 (流畅) | ~8–15 token/s (2×L20,NVLink 互联) |
| 单卡限制 | 不可拆分大于 48GB 的模型到单卡 | 需张量并行(Tensor Parallelism)利用双卡 |
L20 特性:基于 Ada Lovelace 架构,支持 NVLink,显存 48GB,专为推理优化(Transformer Engine、FP8),无显示输出(纯计算卡)。
典型用户画像
- 高校生物信息学实验室
- 冷冻电镜平台技术员
- AI 初创公司训练工程师
- 制药公司分子模拟团队
2.2 方案二:GE430M 135384-MC4T | 4 块 4090 GPU 计算工作站
¥269,000 | AMD 霄龙 7763 (64核 3GHz) / 384GB DDR4 / 4×RTX 4090 48GB + 水冷
核心定位
消费级旗舰 GPU 的极致堆料平台——4×RTX 4090 192GB 显存池 + 64 核霄龙,以消费卡价格实现数据中心级显存容量。
详细应用场景
| 场景 | 具体工作负载 | 能力说明 |
|---|---|---|
| 深度学习训练 | Stable Diffusion XL 全参数训练、LLaMA-3 70B LoRA 微调、Vision Transformer 大规模预训练 | 4×RTX 4090 提供 576 TFLOPS FP32,消费级训练性价比之王 |
| 分子动力模拟 | GROMACS GPU 版百万原子体系、NAMD 大规模并行 MD | 4 卡可分配不同 replica,加速副本交换分子动力学 |
| 蛋白质折叠 | AlphaFold2 批量预测、OpenFold 训练、蛋白质-配体对接 | 192GB 显存可同时加载多个大型蛋白质序列 |
| AI 大模型推理 | 本地部署 70B Q8 高质量模型、多模型并发服务 | 192GB 显存可跑 70B Q8(~78GB)或双开 70B Q4 |
AI 大模型推理能力
| 推理方式 | 支持模型 | 速度/说明 |
|---|---|---|
| GPU 多卡推理(vLLM 张量并行 TP=4) | 70B Q8 (192GB 充裕)、70B Q4 (双开)、32B FP16 | ~10–20 token/s (4×RTX 4090) |
| 限制 | RTX 4090 无 NVLink,多卡通过 PCIe 通信 | 张量并行效率约 70–80%,适合推理而非训练大模型 |
注意:RTX 4090 不支持 NVLink,4 卡间通过 PCIe 4.0/5.0 通信。对于大模型推理,vLLM 的 张量并行(TP=4) 可将模型拆分到 4 卡,但通信开销会导致效率损失(约 20–30%)。适合推理,不适合大模型全参数训练。
典型用户画像
- AI 绘画/大模型创业公司
- 高校深度学习实验室
- 游戏 AI/元宇宙内容团队
- 个人超算爱好者
2.3 方案三:GA650M 230512-MC2D | 电磁仿真计算工作站
¥279,000 | 2×AMD 霄龙 75F3 (64核 3.8GHz) / 512GB DDR5 / 2×RTX Pro 5000 72GB + 水冷 / 双塔式
核心定位
高精度电磁仿真与结构仿真的专业 GPU 平台——2×RTX Pro 5000 144GB 显存 + 双路 64 核 3.8GHz,专为 CST/ANSYS HFSS 等电磁仿真软件优化。
详细应用场景
| 场景 | 具体工作负载 | 能力说明 |
|---|---|---|
| 高精度电磁仿真 | CST Studio Suite 时域/频域求解、ANSYS HFSS 大规模天线阵列、FEKO 电大目标散射 | RTX Pro 5000 的 FP64 双精度性能(10 TFLOPS)加速电磁矩阵求解 |
| 结构显式仿真 | ABAQUS/Explicit 大型碰撞模型、LS-DYNA 金属成形 | GPU 加速显式动力学中的接触算法 |
| 流体仿真 | ANSYS Fluent GPU 求解器、OpenFOAM 加速版 | 144GB 显存可加载千万级网格的 CFD 模型 |
| AI 辅助仿真 | 70B Q8 模型辅助仿真参数优化、结果智能解读 | 144GB 显存可流畅运行 70B Q8 高质量模型 |
AI 大模型推理能力
| 推理方式 | 支持模型 | 速度/说明 |
|---|---|---|
| GPU 多卡推理(NVLink) | 70B Q8 (144GB 充裕)、70B Q4 (有余量)、32B FP16 | ~12–20 token/s (2×Pro 5000,NVLink 互联) |
| 专业优势 | RTX Pro 5000 支持 ECC、双精度、ISV 认证 | 适合需要高精度 + AI 辅助的科研场景 |
RTX Pro 5000 特性:Ada 架构专业卡,72GB GDDR6 ECC 显存,支持 NVLink,FP64 性能 10 TFLOPS,通过 CST/ANSYS 等 ISV 认证。
典型用户画像
- 通信设备公司电磁仿真工程师
- 军工单位雷达散射研究员
- 汽车主机厂电磁兼容实验室
- 天线设计公司技术总监
2.4 方案四:AX450 132512-MCE | 全能电磁仿真 GPU 工作站
¥355,000 | Xeon 6952P (96核 3.2GHz) + 水冷 / 512GB DDR5 / RTX Pro 6000D 84GB + 水冷
核心定位
单卡超大显存的电磁仿真旗舰——RTX Pro 6000D 84GB 单卡显存 + 96 核 Xeon,实现"十亿级网格电磁仿真 + 大模型推理"的融合。
详细应用场景
| 场景 | 具体工作负载 | 能力说明 |
|---|---|---|
| 大规模电磁仿真(时域/频域) | CST 十亿级网格时域仿真、ANSYS HFSS 整机天线布局、电磁脉冲防护设计 | 84GB 显存可加载 9.6 亿网格的电磁模型(图片标注) |
| CPU+GPU 全能型 | 频域求解(CPU 为主)+ 时域求解(GPU 加速)混合仿真 | 96 核 Xeon 处理频域矩阵,Pro 6000D 加速时域步进 |
| AI 辅助电磁设计 | 70B Q4 模型辅助天线设计、电磁兼容规则智能检查 | 84GB 单卡显存可独立运行 70B Q4,无需多卡拆分 |
AI 大模型推理能力
| 推理方式 | 支持模型 | 速度/说明 |
|---|---|---|
| GPU 单卡推理 | 70B Q4 (84GB 充裕)、70B Q8 (接近上限 ~78GB) | ~15–25 token/s (RTX Pro 6000D) |
| 优势 | 单卡 84GB 无需多卡通信开销 | 推理效率最高,适合实时交互 |
RTX Pro 6000D 特性:Blackwell 架构数据中心级专业卡,84GB GDDR6 ECC 显存,FP32 80 TFLOPS,专为大规模仿真和 AI 设计。
典型用户画像
- 航天五院电磁仿真专家
- 华为基站天线研发团队
- 电磁脉冲防护研究院
2.5 方案五:GX660M 235640-MD4A | 极致超级计算工作站
¥620,000 | 2×AMD 霄龙 75F3 (64核 3GHz) / 640GB DDR5 / 4×A100 80GB + 水冷 / 双塔式
核心定位
数据中心级 AI 训练与推理平台——4×A100 320GB 显存池 + NVLink 全互联 + 640GB 内存,单台即可替代小型 GPU 集群。
详细应用场景
| 场景 | 具体工作负载 | 能力说明 |
|---|---|---|
| 超大规模仿真计算 | 电磁仿真(十亿级网格 CFD)、流体仿真(LES 大涡模拟)、EDA 后仿(亿门级芯片验证) | 4×A100 通过 NVLink 全互联,显存带宽 2TB/s+ |
| EDA 后仿计算 | Synopsys VCS 大规模回归测试、Cadence Xcelium 仿真加速 | GPU 加速数字仿真中的事件驱动算法 |
| 蛋白质折叠 | AlphaFold2 大规模批量预测、蛋白质-蛋白质相互作用网络 | 320GB 显存可同时加载数十个大型蛋白质序列 |
| 深度学习训练 | LLaMA-3 70B 全参数微调、GPT 风格模型预训练、多模态大模型训练 | A100 的 Tensor Core 加速混合精度训练 |
| 虚拟加速 | 虚拟机 GPU 直通(vGPU),支持 4–8 个虚拟工作站同时使用 | 640GB 内存支撑多虚拟机隔离运行 |
AI 大模型推理能力
| 推理方式 | 支持模型 | 速度/说明 |
|---|---|---|
| GPU 多卡推理(NVLink TP=4) | 70B FP16 (140GB,充裕)、70B Q8 (双开)、671B Q4 (~400GB,需 CPU offloading) | ~15–25 token/s (4×A100,NVLink 高效互联) |
| 训练能力 | 70B 全参数 LoRA 微调、14B 全参数微调 | 4×A100 NVLink 是训练 70B 模型的最低配置 |
A100 特性:第三代 Tensor Core,80GB HBM2e 显存,NVLink 3.0(600GB/s 卡间带宽),支持 MIG(多实例 GPU),数据中心级可靠性。
典型用户画像
- 国家级实验室 GPU 计算中心
- 头部 AI 公司训练基础设施团队
- 芯片设计公司验证加速团队
- 大型制药公司蛋白质组学中心
2.6 方案六:GX660M 229768-MD4H | GPU 超算共享服务器平台
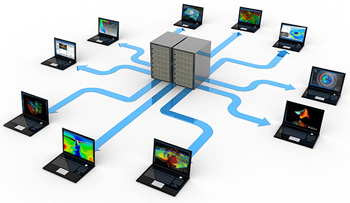
¥920,000 | 2×AMD 霄龙 75F3 (64核 3GHz) / 768GB DDR5 / 4×RTX Pro 6000 96GB (MaxQ) + 水冷 / 双塔式
核心定位
共享/虚拟/私有云全能型高性能异构超算平台——4×RTX Pro 6000 384GB 显存池 + 768GB 内存,为团队提供 "GPU 即服务"。
详细应用场景
| 场景 | 具体工作负载 | 能力说明 |
|---|---|---|
| 共享 GPU 服务器 | 5–10 人团队通过 vGPU 远程共享 4 张 GPU,各跑不同 AI 模型 | 768GB 内存 + 384GB 显存支撑多用户隔离 |
| 虚拟图形工作站 | 远程 SolidWorks/CATIA/ANSYS 图形会话,GPU 加速三维渲染 | RTX Pro 6000 的图形 + 计算双能力 |
| 私有云 AI 平台 | 内部部署 OpenAI 兼容 API 服务,供全公司调用 | 4 卡可服务 20+ 并发请求 |
| 深度学习训练 | 多模态大模型(图文/视频)预训练、AIGC 模型训练 | 384GB 显存可加载 70B 模型 + 大批量数据 |
| 科学计算 | GPU 加速的量子化学、分子动力学、气候模式 | MaxQ 版本优化能效比,适合 24×7 运行 |
AI 大模型推理能力
| 推理方式 | 支持模型 | 速度/说明 |
|---|---|---|
| GPU 多卡推理(NVLink TP=4) | 70B FP16 (140GB,非常充裕)、671B Q4 (~400GB,接近上限) | ~20–35 token/s (4×Pro 6000,NVLink) |
| 多模型并发 | 同时运行 2×70B FP16 + 4×14B Q4 | 384GB 显存池灵活分配 |
| 共享服务 | 10 用户各跑 7B–14B 模型 | vGPU 分区隔离 |
RTX Pro 6000 (MaxQ) 特性:Blackwell 架构,96GB GDDR6 ECC 显存,NVLink 4.0,MaxQ 优化功耗与散热,适合数据中心部署。
典型用户画像
- 大型企业 AI 中台架构师
- 科研院所 GPU 共享平台管理员
- AIGC 创业公司技术总监
- 设计院 BIM+AI 融合团队
2.7 方案七:GX670M 2311T-ME4H | 海量数据计算共享平台
¥1,150,000 | 2×Xeon 金牌 6530 (64核 2.7GHz) / 1TB DDR5 / 4×H200 141GB + 水冷 / 双塔式
核心定位
桌面超算的终极形态——4×H200 564GB 显存池 + 1TB 内存 + NVLink 4.0,可加载 671B 超大模型,单台算力媲美小型数据中心。
详细应用场景
| 场景 | 具体工作负载 | 能力说明 |
|---|---|---|
| 最强大模型推理 | 本地私有化部署 671B Q4 量化模型(如 DeepSeek-R1 671B)、多 Agent 智能体团队(各配 70B 独立模型) | 564GB 显存可加载 671B Q4(~400GB),剩余 164GB 用于长上下文 |
| 海量数据分析 | PB 级数据实时分析、基因组全关联分析、金融高频交易数据挖掘 | 1TB 内存 + H200 的 HBM3e 高带宽加速数据吞吐 |
| 异构 HPC | CPU+GPU 混合并行计算、MPI+CUDA 异构程序、大规模 N 体模拟 | H200 的 FP8 Transformer Engine 加速 AI+HPC 融合负载 |
| AI 模型训练 | GPT-4 级别模型预训练、多模态大模型(图文音视频)全参数训练、强化学习(RLHF) | 4×H200 提供 900+ TFLOPS FP8 算力 |
| 团队共享平台 | 20+ 人团队同时使用不同规模模型 | 1TB 内存支撑大规模并发会话 |
AI 大模型推理能力
| 推理方式 | 支持模型 | 速度/说明 |
|---|---|---|
| GPU 多卡推理(NVLink 4.0 TP=4) | 671B Q4 (~400GB,可加载)、70B FP16 (三开)、70B Q8 (四开) | ~5–10 token/s (671B) / ~25–40 token/s (70B) |
| 训练能力 | 671B 模型 LoRA 微调、70B 全参数微调、14B 全参数预训练 | H200 的 FP8 精度加速训练 2–3 倍 |
| 多模型并发 | 同时运行 1×671B + 2×70B + 4×14B | 564GB 显存 + 1TB 内存的极致资源池 |
H200 特性:Hopper 架构升级版,141GB HBM3e 显存(带宽 4.8TB/s),NVLink 4.0(900GB/s 卡间带宽),FP8 Transformer Engine,目前单卡显存最大的数据中心 GPU。
典型用户画像
- 国家级 AI 实验室首席科学家
- 头部大模型公司(OpenAI/Anthropic 级别)基础设施负责人
- 顶级量化私募 AI 研究部
- 宇宙学/核物理/基因组学国家级项目
三、AI 大模型推理能力对照表 { #section-ai-deployment}
3.1 大模型显存需求参考
| 模型规模 | Q4_K_M 量化 | Q8_0 量化 | FP16 精度 | FP8 精度 |
|---|---|---|---|---|
| 7B | ~4.5 GB | ~8 GB | ~14 GB | ~7 GB |
| 14B | ~9 GB | ~16 GB | ~28 GB | ~14 GB |
| 32B | ~20 GB | ~36 GB | ~64 GB | ~32 GB |
| 70B | ~43 GB | ~78 GB | ~140 GB | ~70 GB |
| 671B | ~400 GB | ~730 GB | ~1.3 TB | ~650 GB |
3.2 全系 7 款配置大模型推理能力总表
| 方案 | 型号 | 价格 | GPU 配置 | 总显存 | 单卡最大 | 多卡聚合上限 | 核心用途 |
|---|---|---|---|---|---|---|---|
| 1 | AE430 135256-MC2L | ¥142,000 | 2×L20 48GB | 96GB | 48GB | 70B Q4 | 深度学习/冷冻电镜/蛋白质折叠 |
| 2 | GE430M 135384-MC4T | ¥269,000 | 4×RTX 4090 48GB | 192GB | 48GB | 70B Q8 | 消费级训练/AI 绘画/多模型并发 |
| 3 | GA650M 230512-MC2D | ¥279,000 | 2×RTX Pro 5000 72GB | 144GB | 72GB | 70B Q8 | 电磁仿真/结构仿真/高精度计算 |
| 4 | AX450 132512-MCE | ¥355,000 | 1×RTX Pro 6000D 84GB | 84GB | 84GB | 70B Q4/Q8 | 十亿级网格电磁仿真/单卡旗舰 |
| 5 | GX660M 235640-MD4A | ¥620,000 | 4×A100 80GB | 320GB | 80GB | 70B FP16 | 数据中心级训练/虚拟加速/EDA |
| 6 | GX660M 229768-MD4H | ¥920,000 | 4×RTX Pro 6000 96GB | 384GB | 96GB | 671B Q4 (尝试) | 共享 GPU 服务器/私有云/多模态训练 |
| 7 | GX670M 2311T-ME4H | ¥1,150,000 | 4×H200 141GB | 564GB | 141GB | 671B Q4 (流畅) | 终极超算/671B 模型/国家级项目 |
3.3 多卡并行策略与效率
| 平台 | 互联方式 | 卡间带宽 | TP=4 效率 | 推荐并行策略 |
|---|---|---|---|---|
| 2×L20 | NVLink | 600GB/s | ~90% | 张量并行 TP=2 |
| 4×RTX 4090 | PCIe 5.0 | 64GB/s | ~70% | 张量并行 TP=4(推理可用) |
| 2×RTX Pro 5000 | NVLink | 900GB/s | ~92% | 张量并行 TP=2 |
| 1×RTX Pro 6000D | 无 | — | 100% | 单卡推理(无通信开销) |
| 4×A100 | NVLink 3.0 | 600GB/s | ~85% | 张量并行 TP=4 / 流水线并行 PP=2 |
| 4×RTX Pro 6000 | NVLink 4.0 | 900GB/s | ~90% | 张量并行 TP=4 |
| 4×H200 | NVLink 4.0 | 900GB/s | ~92% | 张量并行 TP=4 / 专家并行 EP=4 |
关键结论:NVLink 是多卡大模型推理的核心——RTX 4090 因无 NVLink,4 卡 TP=4 效率仅 70%,适合预算敏感的训练场景;A100/H200/Pro 系列因 NVLink 全互联,效率达 85–92%,是生产级推理的首选。
3.4 推理速度参考
| 模型 | 平台 | 量化 | 速度 (token/s) | 说明 |
|---|---|---|---|---|
| 70B Q4 | 2×L20 96GB | Q4_K_M | 8–15 | 入门级 70B 推理 |
| 70B Q8 | 4×RTX 4090 192GB | Q8_0 | 10–20 | 消费卡性价比之选 |
| 70B Q8 | 2×Pro 5000 144GB | Q8_0 | 12–20 | 专业卡 ECC 保障 |
| 70B Q4 | 1×Pro 6000D 84GB | Q4_K_M | 15–25 | 单卡最高效 |
| 70B FP16 | 4×A100 320GB | FP16 | 15–25 | 数据中心级精度 |
| 70B FP16 | 4×Pro 6000 384GB | FP16 | 20–35 | 共享平台多开 |
| 671B Q4 | 4×H200 564GB | Q4_K_M | 5–10 | 桌面超算终极形态 |
四、多卡并行技术:NVLink vs PCIe { #section-multi-gpu}
4.1 为什么多卡需要高速互联?
大模型推理时,模型权重需拆分到多张 GPU。每生成一个 token,各卡需交换中间结果(激活值)。若卡间带宽不足,通信时间将远超计算时间。
| 互联技术 | 带宽 | 延迟 | 适用场景 |
|---|---|---|---|
| NVLink 4.0 | 900GB/s | <1μs | 大模型训练与推理(A100/H200/Pro) |
| NVLink 3.0 | 600GB/s | <1μs | 数据中心级训练(A100) |
| PCIe 5.0 x16 | 64GB/s | ~1μs | 消费级多卡(RTX 4090) |
| PCIe 4.0 x16 | 32GB/s | ~1μs | 旧平台 |
4.2 不同平台的实际表现
70B 模型推理(生成 1 个 token)的通信开销:

4×H200 (NVLink 4.0):
  计算: ~15ms  |  通信: ~2ms  |  效率: ~92% ✅

4×A100 (NVLink 3.0):
  计算: ~20ms  |  通信: ~3ms  |  效率: ~85% ✅

4×RTX 4090 (PCIe 5.0):
  计算: ~18ms  |  通信: ~8ms  |  效率: ~70% ⚠️

2×L20 (NVLink):
  计算: ~25ms  |  通信: ~2ms  |  效率: ~90% ✅
4.3 软件层面的多卡策略
| 框架 | 支持的并行方式 | 适用平台 |
|---|---|---|
| vLLM | 张量并行 (TP)、流水线并行 (PP) | 全部 |
| TensorRT-LLM | TP、PP、专家并行 (EP) | NVLink 平台 |
| Ollama | 自动多 GPU 负载均衡 | 全部(效率一般) |
| DeepSpeed | ZeRO、TP、PP | 训练为主 |
| Megatron-LM | TP、PP、EP | NVLink 平台 |
推荐:生产级 70B+ 推理首选 vLLM + TensorRT-LLM 组合,配合 NVLink 平台可实现极致吞吐。
五、常见问题与硬件配置分析 { #section-faq}
5.1 4×RTX 4090 能训练 70B 模型吗?
Q:GE430M 的 4×RTX 4090 能全参数训练 70B 模型吗?
A:不能全参数训练,但可 LoRA 微调。70B FP16 需 140GB 显存,4×RTX 4090 共 192GB,但:
- 无 NVLink,ZeRO-3 优化器状态通信极慢
- 显存碎片化严重,实际可用 <160GB
- 消费卡无 ECC,长时间训练可能出错
建议:4×RTX 4090 适合 14B–32B 全参数训练 或 70B LoRA 微调,70B 全参数训练请选 4×A100/H200。
5.2 为什么方案 4 只有 1 张 GPU?
Q:AX450 132512-MCE 只有 1 张 RTX Pro 6000D,凭什么卖 ¥35 万?
A:这张卡的定位是 "单卡极致 + 十亿级网格电磁仿真"。RTX Pro 6000D 84GB 是 Blackwell 架构数据中心级专业卡:
- 84GB ECC 显存可加载 9.6 亿网格电磁模型
- FP64 双精度性能 10 TFLOPS,电磁矩阵求解必需
- 单卡无需多卡通信,推理效率 100%
- 通过 CST/ANSYS 等 ISV 认证
对于电磁仿真工程师,1 张 Pro 6000D 的价值 > 4 张 RTX 4090(后者无 FP64、无认证)。
5.3 H200 相比 A100 提升多少?
Q:方案 7 的 H200 比方案 5 的 A100 贵近一倍,值吗?
| 维度 | A100 80GB | H200 141GB | 提升 |
|---|---|---|---|
| 显存容量 | 80GB | 141GB | +76% |
| 显存带宽 | 2TB/s | 4.8TB/s | +140% |
| FP8 算力 | ~800 TFLOPS | ~1000 TFLOPS | +25% |
| NVLink 带宽 | 600GB/s | 900GB/s | +50% |
| Transformer Engine | 第一代 | 第三代 | 精度/效率双提升 |
结论:H200 的核心优势是 显存容量和带宽。对于 671B 大模型,A100 320GB 不够(需 CPU offloading),H200 564GB 则可完整加载。若业务涉及 70B+ 模型,H200 是唯一选择。
5.4 多卡平台的功耗与散热
Q:4×H200 满载时功耗多少?办公室能放吗?
A:绝对不能放普通办公室。
| 组件 | 满载功耗 |
|---|---|
| 4×H200 | 700W (175W×4) |
| 2×Xeon 6530 | 300W |
| 系统其他 | 200W |
| 总计 | ~1200W |
需要 独立机房、空调恒温 22°C、UPS 不间断电源。双塔式机箱 + 水冷系统噪音可达 55–65 分贝。
5.5 共享服务器怎么分配 GPU?
Q:GX660M 229768-MD4H 作为共享服务器,4 张 GPU 怎么分给团队?
| 分配策略 | 适用场景 | 显存分配 |
|---|---|---|
| vGPU 虚拟化 | 5–10 人轻量使用 | 每用户 8–16GB vGPU |
| MIG(仅 A100) | 7 人独立实例 | 每实例 10GB |
| 容器隔离(Docker) | 开发团队 | 按需分配整卡或分卡 |
| 时间片轮转 | 训练任务排队 | 独占整卡,用完释放 |
推荐:推理服务用 vGPU 或容器隔离,训练任务用时间片轮转。
5.6 671B 模型推理实际体验如何?
Q:4×H200 跑 671B Q4,5–10 token/s 能用吗?
A:不适合实时对话,但适合后台批处理。
| 场景 | 5–10 token/s 是否够用 | 说明 |
|---|---|---|
| 实时聊天 | ❌ 太慢 | 人类舒适阈值 >20 token/s |
| 代码生成 | ⚠️ 可接受 | 短代码片段(<100 token)等待 10–20 秒 |
| 长文档分析 | ✅ 适合 | 100 页文档分析,后台运行 5 分钟 |
| 知识库问答 | ✅ 适合 | 预加载上下文,单次查询 |
| 批量数据处理 | ✅ 非常适合 | 夜间跑批,无需人工等待 |
优化建议:配合 投机解码(Speculative Decoding) 或 Medusa 解码,可将 671B 模型速度提升 2–3 倍。
免责声明:本文基于 UltraLAB 图形工作站基准配置表 2026v1 整理撰写。硬件配置与价格以厂商最新报价为准。多卡大模型推理速度受模型版本、量化方案、框架实现、NVLink/PCIe 带宽等多因素影响,实际表现可能存在差异。RTX 4090 为多卡配置时,因无 NVLink,不建议用于生产级大模型训练。


